引言
海外算力通道被进一步收紧,限制从“芯片进不来”延伸到“远程算力用不了”。对于正在探索“Token 工厂”模式的中国 AI 产业,这既是压力也是倒逼:一边要尽快把模型能力转化为可计量、可盈利的 Token 产能,另一边又必须在国产硬件与存量集群上保障稳定供给与成本可控。北京智源与清昴智能联合发布的“国产 Token 工厂端到端推理优化方案”与众智 FlagOS 的落地商用,正是对这道工程题的正面回应。
下半场的关键不再是“能不能做出模型”,而是“能否以可承受的价格、稳定的质量,把每一个 Token 交付到真实业务”。这背后,是对统一软件栈、异构资源调度、推理内核优化与产业协同的系统性重构。
“剪刀差”下的工程命题:从电价逻辑到 Token 经济学
模型快、基建慢的周期错配
大模型更新步伐以周计,硬件基础设施却往往按年升级。这种“剪刀差”意味着:如果软件栈无法快速适配新架构、沉淀跨芯片复用的优化经验,再昂贵的新卡也可能“跑不动新模型”。反过来,只有以软件为中枢,把异构硬件在系统层抽象成标准化产能,才能在硬件迭代节奏之外,给业务侧持续稳定的 Token 供给。
供应链安全与成本曲线的两难
“电价逻辑”是理解智能时代成本曲线的一个形象类比。工业时代的成本竞争离不开可控的本土能源;在智能时代,则体现为“每百万 Token 的可承受单价”。海外算力受限使得供应链安全成为硬约束,国产芯片的可用性、可维护性与可扩展性被放到更核心的位置。问题不只是“有无”,更是“能否稳定、低价地交付 Token”。
从“按卡采购”到“按秒交付”的翻译器
企业采购习惯是按卡、按机架规模,而业务需求是按秒计费、按延迟约束的 Token 服务。中间需要一座“翻译器”:把闲置的、异构的、难以统一管理的国产算力,组织成高可靠、可计量、对上层透明的标准化产能。这正是通往 Token 工厂的必由之路。
统一软件栈的价值:众智 FlagOS 的“底座效应”
以开源统一栈串联芯片与模型
众智 FlagOS 的目标,是用一套开放、统一、可复用的系统软件栈,打通“多模型 × 多芯片”的组合爆炸问题。当前生态已汇聚 21 家芯片企业与 86 家生态伙伴,覆盖 35 款 AI 芯片;底层由通用算子库 FlagGems、训推并行框架 FlagScale、统一编译器 FlagTree 与统一通信库 FlagCX 构成。9 大算子库累计沉淀超过 1,454 个开源 Triton 算子,其中近八百个在至少 5 款国产芯片上达到了原生算子 80% 以上的性能。
这些数字的意义不在“好看”,而在于“复用”:一次优化、多处受益。同一套算子与编译路径可在不同硬件上共享经验,把适配成本从“每新增一款芯片重写一遍”变成“在公共能力上增量优化”。这决定了产业迭代速度与规模化落地的边界。
不改上游、插件接入的工程取向
在框架层,FlagOS 遵循“不 fork 上游”的原则,通过插件化机制零侵入接入 vLLM、SGLang、Megatron-LM 等主流生态,实现单仓库覆盖 20 家厂商后端;在过去半年多次达到新模型发布当天即完成多芯片 Day0 跑通。对 Token 工厂而言,这意味着从模型上线到产能释放的时间大幅缩短,且避免了“各自为战”的碎片化重复劳动。
异构集群的可运营性
统一栈不仅是“能跑通”,更是“可运营”。在生产环境,运维关注的是:
- 单位成本:每百万 Token 的电力与折旧成本
- 服务质量:P99 延迟与吞吐波动
- 多租户隔离:不同业务场景的 QoS 保证
- 异构资源利用:老旧 GPU、国产 NPU、通用 CPU 的协同
FlagOS 的抽象与调度能力,使多芯片集群具备可观测、可控、可预测的服务特性,这是商业化的基础设施门槛。
面向 Token 工厂的端到端优化:从内核到服务
Prefill 与 Decode 的双重瓶颈
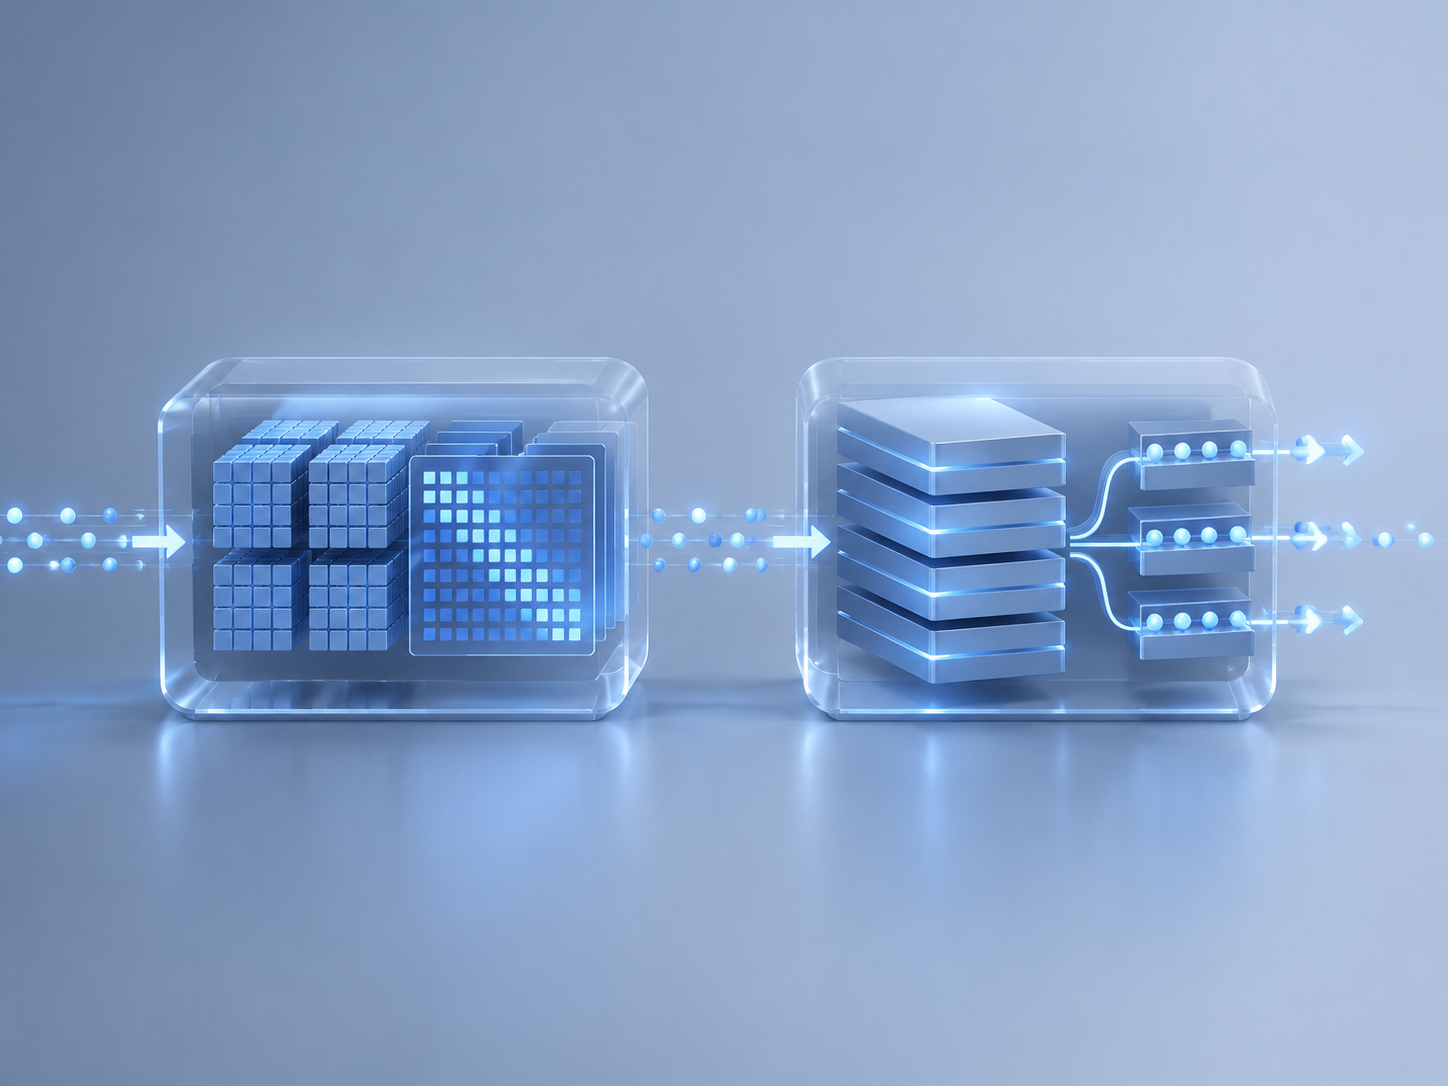
大模型推理周期可粗分为两段:Prefill(计算密集)与 Decode(访存密集)。两段的性能瓶颈与优化策略截然不同:
- Prefill:关注矩阵乘与注意力的吞吐,关键在于算子融合、数据复用与片上并行
- Decode:关注 KV 缓存与内存带宽,关键在于数据布局、分页注意力、动态批处理
此次方案在华为昇腾 910C 集群上针对智谱 GLM-5.3 与 GLM-5.3-Flash 深入到了微秒级内核优化。以 GLM-5.3-Flash 的混合注意力为例,重构了大小块计算路径,协调芯片内向量与矩阵单元并行分工,减少中间结果的片外搬运,显著改善 Prefill 吞吐与稳定性。
Decode 段的内存与并发治理
在 Decode 段,优化重点转向内存与并发:
- KV 缓存分页与压缩:结合页式管理减少碎片,优化访问局部性,降低长序列带来的缓存膨胀
- 动态批与流控:基于流量预测做动态批次合并,控制尾延迟,提升有效吞吐
- Speculative/合并解码:结合较小模型或启发式策略降低平均步长,减少重复计算
- 通信与拓扑感知:在多卡并行中对通信路径进行拓扑约束,减轻跨节点带宽压力
这些策略直击“长序列 + 高并发”场景下的成本与 SLO 矛盾,为商业化服务提供可持续的性能-成本平衡点。
从实验室到生产线:服务化的最后一公里
端到端优化不止于算子与内核,还包括服务侧的工程闭环:
- 负载自适应路由:按序列长度、温度参数、上下文缓存命中率等维度分流到不同后端
- 精细化计费与监控:以 Token 为基本单位,实时追踪成本与产能,避免“黑箱式”开销
- 多租户隔离与熔断:在资源紧张时保障关键业务 SLO,避免级联失败
- 灰度与回滚机制:新内核、新策略随时灰度上线,确保生产安全
这让“能跑得快”的优化真正转化为“可稳定赚钱”的产能。
影响与展望
海外算力通道收窄,使“本土可控的 Token 产能”成为产业基本盘。众智 FlagOS × 清昴智能的联合方案释放出三个信号:
1) 标准化产能成为竞争核心。未来的竞争不只是模型参数与榜单,更是“以何种成本曲线、在多大规模上持续稳定地交付 Token”。统一软件栈、跨芯片复用与服务侧 SLO 工程,将成为衡量基础设施成熟度的新标尺。
2) 开放生态胜于单点突破。在“无单一芯片称霸”的现实下,能否把多样化硬件通过开源、统一、可复用的栈组织起来,决定了整个行业的迭代速度与供给弹性。FlagOS 的 Day0 能力与广泛生态,正在把碎片化的优化变成公共资产。
3) 工程深水区的长期主义。微秒级内核的精进、Decode 段内存治理、调度与计费的服务化,这些看似“琐碎”的工程,恰恰构成 Token 工厂的护城河。真正的优势不在单点性能峰值,而在长期的可运营性、可维护性与跨代复用。
展望未来,几个方向值得持续投入:
- 多模态与长上下文的标准化优化路径,构建跨任务的可复用能力
- 面向异构机房的能耗与碳排优化,以“每百万 Token 的能耗”作为新 KPI
- 大模型训推一体的闭环,使训练端的算子与图优化在推理侧即时复用
- 更细粒度的行业基准,把“Token 经济学”纳入公开透明的评估体系
当“电价逻辑”迁移到智能时代,谁能更早把 Token 变成稳定、可负担、可审计的产能,谁就能在算力受限的环境中掌握主动权。FlagOS 与清昴的这次联合落地,既是一条技术路径,也是一次产业组织方式的示范。
标签: 国芯 Token工厂 FlagOS 推理优化 算力生态
还没有评论
发表评论