引言
个人智能体的竞争已经从“会不会回答”迈向“会不会长期完成事”。在这个方向上,新近开源的Reflex Agent给出了一个颇具工程含金量的答案:用决策模型驱动Agent的核心调度逻辑,用循环工作机制持续推进任务进度,并叠加一套强调无损存取的长期记忆引擎,从而声称在响应速度与长周期执行上实现了显著优势。相比以提示词脚本和工具列表堆砌出的传统框架,这是一种“把大脑装进Harness”的思路。
核心内容
模型驱动Harness:把“决策大脑”置于中枢
多数Agent框架的Harness(调度层)依赖代码流程和提示词模板去组织工具调用与控制流,适应性强但也容易脆弱:场景变化需要频繁改模板,分支爆炸难维护。Reflex Agent选择把决策模型直接嵌入Harness中,让模型承担以下职责:
- 模型路由:根据任务目标与上下文选择使用哪类子模型或工具。
- 技能选择:在多工具、多技能库中选择最合适的技能链。
- 结果审查:对工具输出进行自检与质量判定,触发重试或改道。
- 执行监督:在长链路执行中进行阶段性评估,及时纠偏。
这种“模型驱动Harness”的好处在于,控制逻辑不再死依赖固定模板,面对未见过的分支与异常,决策模型可以在一定范围内做出更灵活的调度。对开发者而言,这意味着更少的提示词工程负担与更强的泛化弹性。当然,风险也随之而来:可解释性与可控性需要通过策略约束、审计日志和安全沙箱去补齐。
Loop Working:从回答到行动的闭环
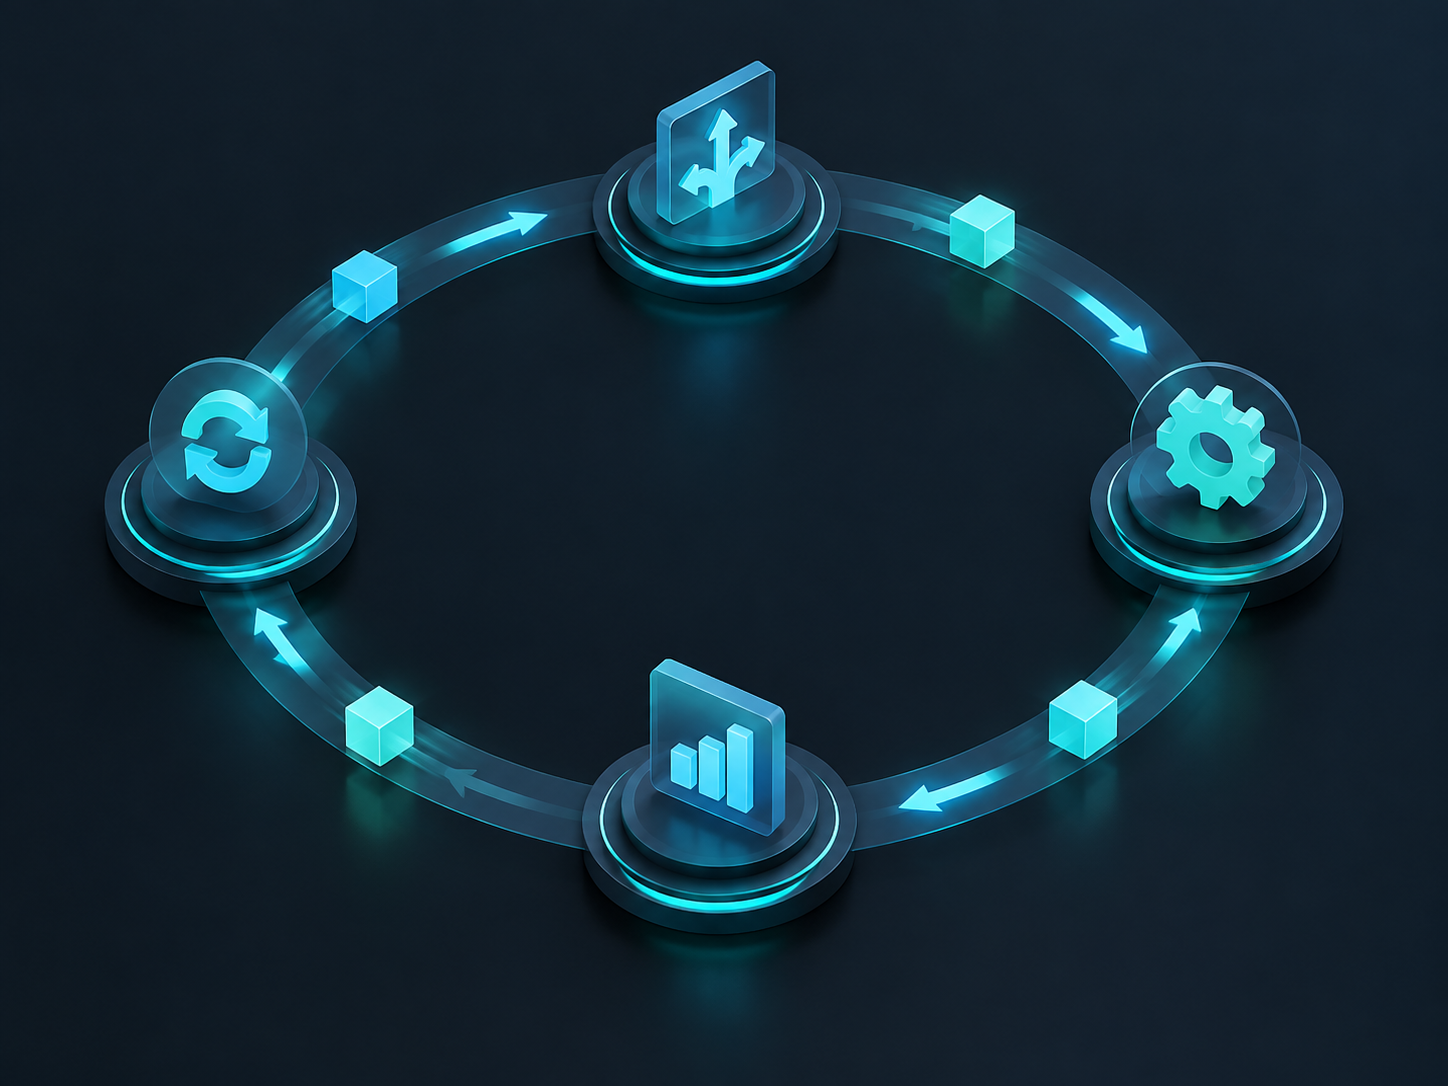
Reflex Agent强调“决策—执行—反馈—再决策”的循环工作机制(Loop Working)。它的重点不在一次性输出正确答案,而在持续推动目标靠拢。例如:
- 面向编程任务:先生成初版代码,运行单元测试,收集错误,再迭代修复。
- 面向研究任务:先搭建资料清单,分阶段检索与阅读,逐步构建结论。
- 面向运营任务:持续监控指标,自动触发脚本与告警,滚动优化策略。
循环工作机制的价值有二:一是降低了“首答正确”的压力,提高整体成功率;二是把长周期任务拆解为阶段性里程碑,有助于持续积累对任务环境的理解。对应的工程挑战也显而易见——如何防止“循环空转”、如何设定收敛条件、如何在成本与收益之间找到平衡。Reflex Agent通过结果审查与监督节点进行约束,这是闭环可靠性的关键。
“无限上下文”:记忆与窗口的工程解题
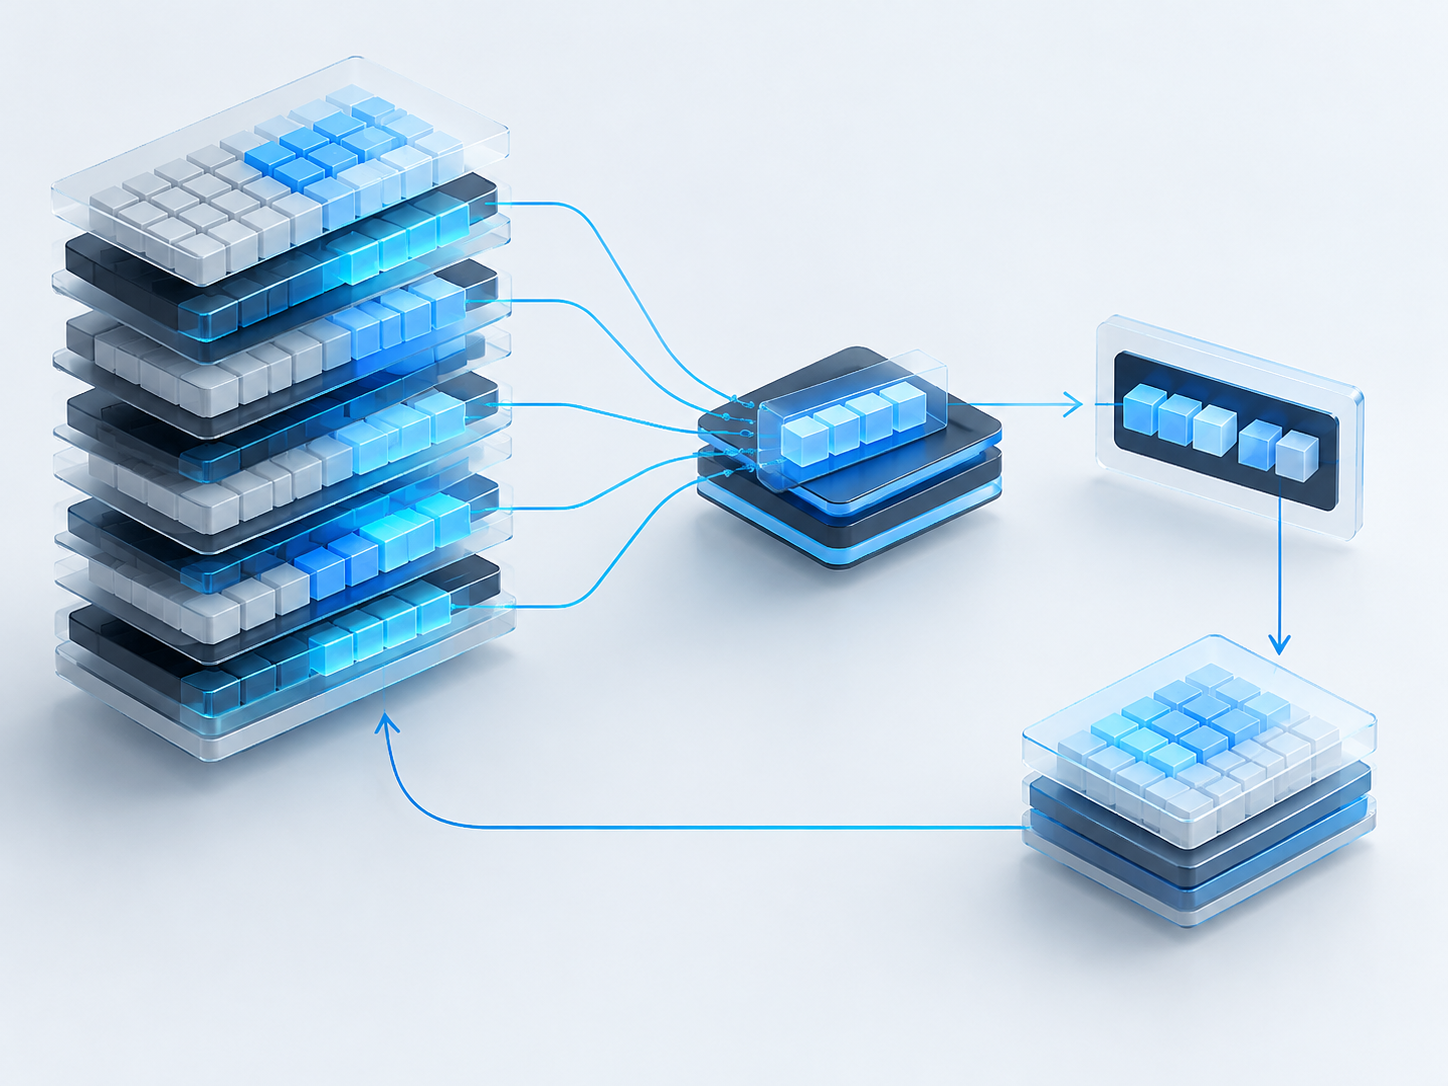
大模型的上下文窗口再大,单次调用也有限。Reflex Agent提出的“无限上下文”并非“魔法扩窗”,而是通过记忆系统重构“长期任务的上下文可用性”:
- 无限记忆:任务相关的信息持续写入记忆库,不被粗暴截断。
- 无损记忆:尽可能保留原始内容及结构,而非只存摘要,减少信息偏差。
- 无损输入:在决策点上按需原文回填,让历史信息以接近原貌参与判断。
这套思路与常见的RAG(检索增强生成)类似,但在“无损”上更进一步:不仅要找得到,还要尽量以原文粒度回流。好处是减少“摘要谬误”,提升长链路决策的稳健性;代价是检索、筛选与重组的开销增加,对索引策略、相似度度量与上下文拼装提出更高要求。真正的工程难点在于“把什么放回去、放多少、以何种结构插入”。如果策略过猛,模型被冗余信息淹没;过严,又失去“无损”的意义。
性能与可复现性:3倍速度背后的因素
Reflex Agent在实测中宣称相对主流Agent(如面向编码的系统)有最高可达3倍的响应速度,这一结论值得从工程侧解读:
- 决策前置减少往返:模型在Harness层面高效路由,减少无效工具调用。
- 记忆回填降低重复:长周期任务中避免“从零开始”的重复询问与生成。
- 流水化与并行化:循环机制在阶段边界上可能启用并行检索与校验。
- 流式输出体验:优化首令时延(TTFT)与分段生成,提升主观“快感”。
需要强调的是,速度对比高度依赖测试集、硬件与网络条件,以及是否使用相同的基础模型与工具栈。要让“3倍更快”具备可复现性,必须提供清晰的基准范式、公开的脚本、明确的评测维度(如首字节延迟、端到端完成时长、重试次数、成功率等)。开源与MIT协议降低了重复验证门槛,这是积极信号,但行业仍需统一的长周期Agent评测标准,才能让“快与好”真正落地可比。
影响与展望
Reflex Agent把三个趋势合在了一起:模型驱动的控制逻辑、以循环推进为核心的任务执行方式、以及强调原文回填的长期记忆。这种组合面向的是“复杂、长链、跨阶段”的真实任务,而非一次性对话。其潜在影响体现在以下方面:
- 对开发者:更少提示词拼装,更关注技能库与决策策略。评测、审计与回放工具将成为标配能力。
- 对企业落地:长周期任务的成本可控性提升,复用记忆降低重复支出,适合运维、客服、研究、自动化测试等场景。
- 对模型生态:决策模型的位置前移,可能弱化“提示词魔法”的主导地位,推动Agent从脚本化走向策略化。
- 对安全与合规:长期记忆带来隐私保护、数据留存与访问控制的新挑战,需要细粒度权限管理、可删除与可追溯机制。
展望来看,Reflex Agent类的系统将继续在三个方向迭代:
- 更强的“可解释决策”:把每一步路由、审查与回填可视化,便于调试与合规。
- 更好的“记忆选择器”:从简单相似度到因果感知与任务态驱动的检索策略,减少无关噪音。
- 更稳的“闭环控制”:通过预算上限、收益估计与风险监控,防止循环走偏与资源浪费。
当Agent不再止步于回答,而是围绕目标持续行动,且能在长期记忆的支撑下保持一致性,个人智能体才真正接近“用得住、用得久”的形态。Reflex Agent的开源是一块重要的拼图,接下来属于标准化评测、工程打磨与场景化落地的时间。
标签: 智能体 决策模型 长上下文 开源 个人Agent
还没有评论
发表评论