引言
当电音节遇上大模型原生智能体,舞台边界不再只是DJ与观众的双向对话。10月17日至18日在上海举行的 The Magic of Tomorrowland 2026,将首次把AI智能体带到超大规模电音现场:听众不仅点歌,更能把灵感“变成”音乐,现场生成、现场上墙,甚至融入主舞台编排。这次尝试由智能体手机与开放开发工具链串起,展示了AI终端如何真正承接创意并把它推向声音系统、灯光与人群共振之中。
核心内容
智能体如何把灵感变成电音
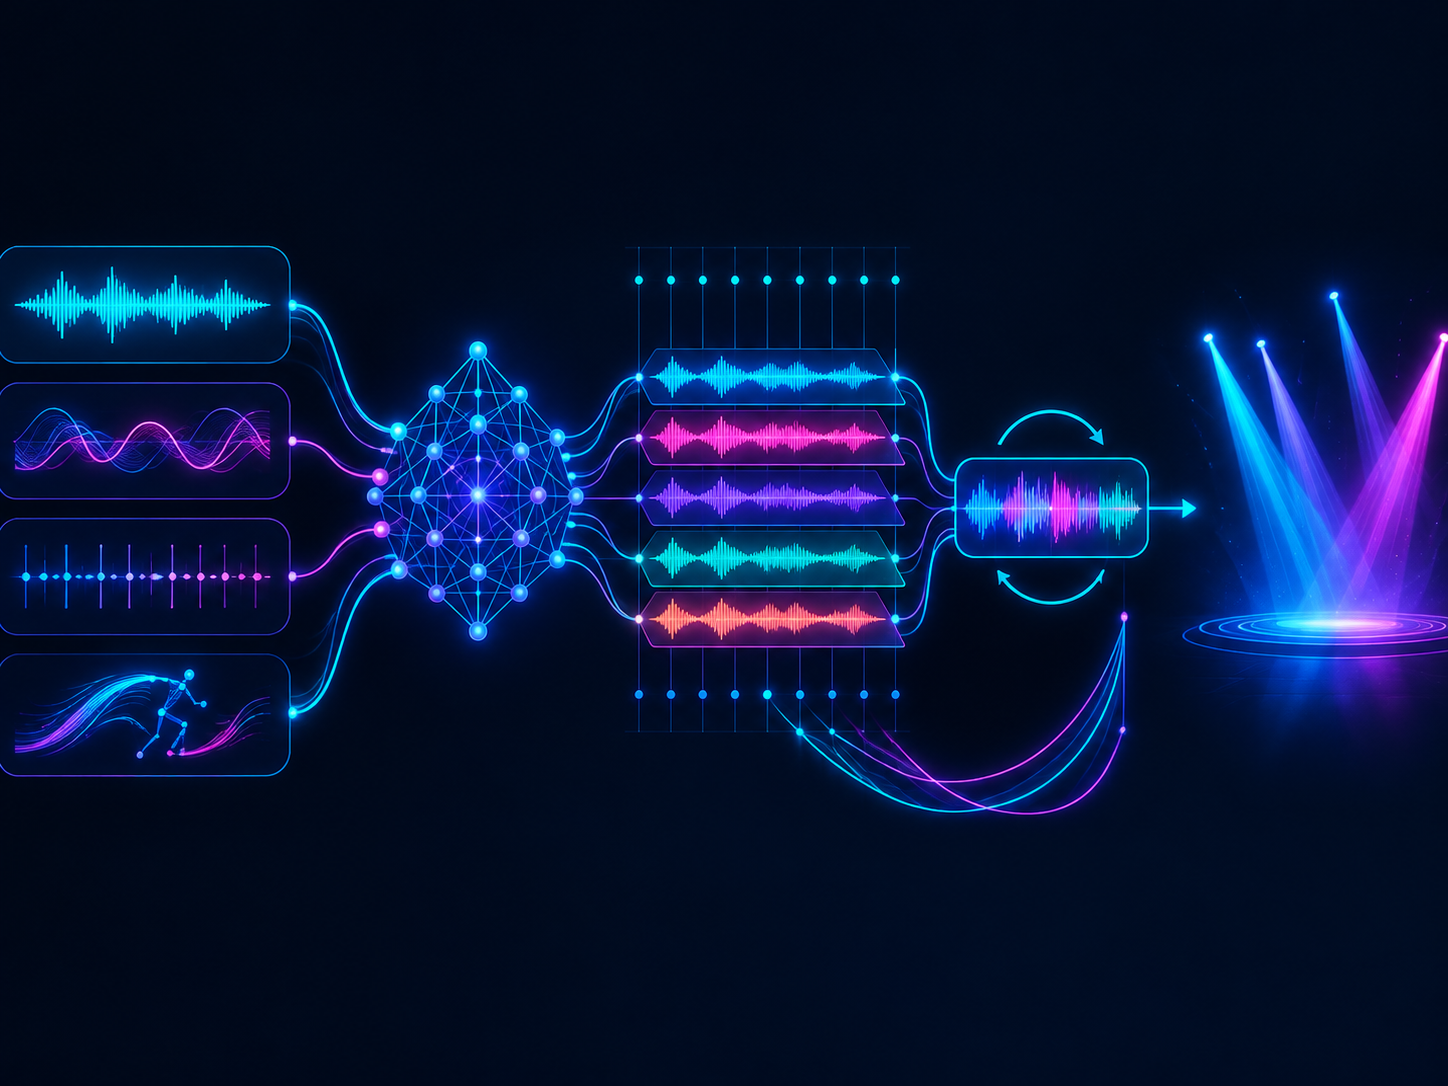
现场共创的关键在于“意图捕捉—风格化生成—可演出化输出”三步走:
- 意图捕捉:观众通过语音描述、哼唱、节拍敲击或手势加速度等多模态信号,向个人智能体发出创作指令。智能体理解BPM、情绪、律动密度与音色偏好,将“感觉”转译为结构化音乐参数。
- 风格化生成:基于音乐生成模型(如StepAudio 3),在端侧或边缘侧低时延推理,生成鼓组、贝斯线、Pad与Lead等分轨Stems,支持变化长度的Drop与Build-up,保证与现场Key与BPM对齐。
- 可演出化输出:系统对生成片段进行人耳友好压限、调性校准与Loop整形,进入候选池。DJ或主舞台智能编排器实时挑选、交叉淡入,与当前曲目合拍衔接,避免“跳戏”。
这一流程的难点在于低时延与稳定性,需要端云协同:常用控制在端侧完成,复杂渲染由场馆边缘算力接管,并以MIDI/OSC桥接灯光、烟火等舞台控制,形成声光一体的共创反馈。
开放式终端与开发生态
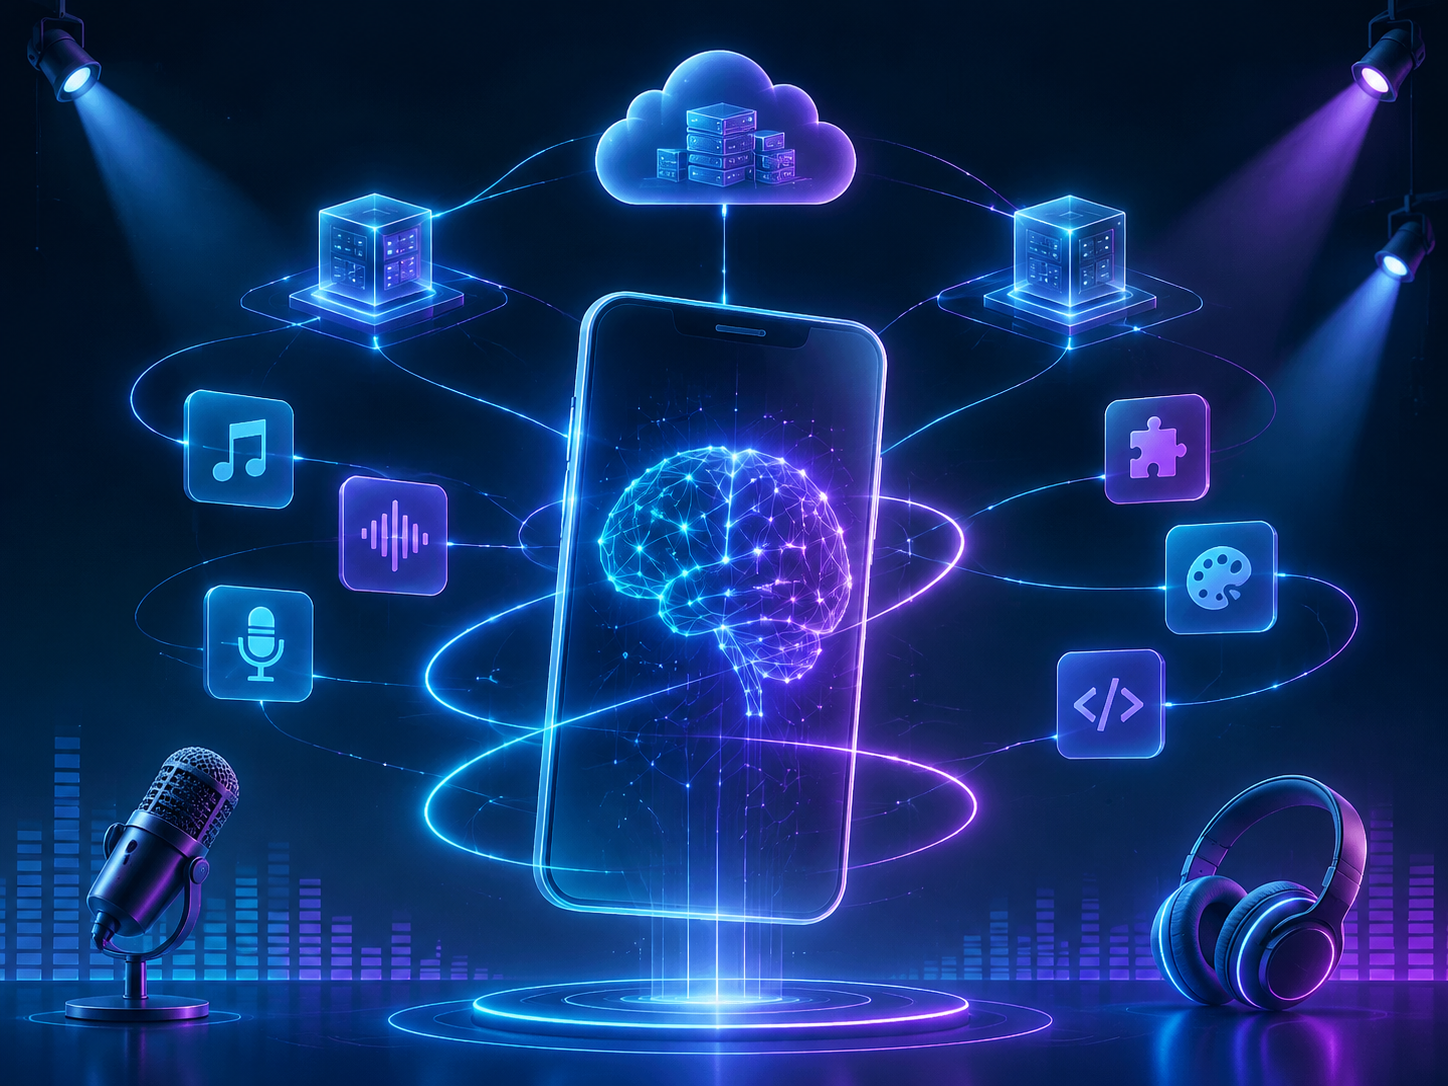
此次落地依赖于大模型原生的终端与开发环境:
- 智能体操作系统将语音、传感器、网络、模型推理打通,个人智能体(如Amoo)成为“会理解、会执行、会协作”的创作助手。
- 面向创客的自然语言IDE(如Step Studio)可快速生成AI App与Skill,让开发者为电音节定制“采样上墙”“风格迁移”“合拍修正”等模块,并通过MCP、A2A等协议连接外部服务与专业智能体。
- 终端开放模型、系统与硬件能力,意味着手机不再只是播放设备,而是口袋里的“合成器+编曲机+智能制作人”,能把个人审美实时注入公共声场。
这种“模型+软件+硬件”深度耦合,降低了音乐创作与分发的门槛,让开放共创从技术概念走进人群之中。
从观众到共创者:体验与规则
共创并非“人人上台”,而是“人人被听见”:
- 策展机制:系统对提交作品做相似度去重、质量评估与内容安全审查,社区投票与DJ甄选共同决定舞台呈现。
- 归属与版权:建议采用“现场共创”协议,明确观众、平台、模型与DJ的署名与分成,区分一次性演出素材与可发行曲目,避免后续纠纷。
- 公平与多样性:引入风格均衡与新颖度激励,避免热门风格单一化,确保小众灵感也有被听到的机会。
影响与展望
- 对音乐产业:制作门槛被进一步拉低,现场成为“首发渠道”,曲目从“作品”演化为“过程”,长尾风格与在地文化将被快速孵化。新角色将涌现:Agent Jockey(智能体驾驭者)、Skill 设计师、现场数据策展人。
- 对AI终端:这是大模型原生终端的标志性场景证明,端云协同、多模态理解、实时生成的价值被整体呈现。智能体手机不再竞速参数,而是竞速“场景生产力”。
- 风险与挑战:风格拟态导致的侵权、审美趋同、Prompt刷屏与恶意内容注入,都需要以风格守护、内容水印、稳态延迟控制与人机协同策展来应对。
- 下一步想象:共创将超越音频,联动舞美、灯光、视觉与特效,形成多模态合成现场;生理信号与群体情绪可作为控制维度,驱动自适应编排;个体的“声音身份”将可跨场景携带,沉淀为可交易、可复用的创作资产。
当AI把“听众”升级为“合作者”,舞台的能量被重新分配。电音节不再只是播放名曲的宏大场域,而是集体智能与个人表达的实时熔炉。真正的考验,是在技术充分的前提下,让规则与审美同样先进,让每一次Drop都来自此刻无可替代的共同灵感。
标签: AI音乐 大模型原生终端 人机共创 实时生成
还没有评论
发表评论