引言
当大模型从“写得好”转向“做得准”,一个能在不确定中权衡取舍、在有限计算预算内做出稳健判断的决策中枢,成为智能体与本地化智能系统的关键组件。Hugging Face 最新一次 Decision Index 0.3.2 榜单更新,来自中国的 StartLux 以 StartLux-Decision-v1.1-27B Instant 拿下 69.1 分、位列全球第一,在 173 项公开复现模型中拔得头筹,并把第二名甩在近 3 分身后。这不仅是“分数领先”,更是在方法、评测与工程落地上的系统性突破:双路线(Instant 与 AutoThink)覆盖不同复杂度的任务,原创 RLCD² 训练方法校准“该想多久、何时收手”的推理行为,还配合 DecisionPivot 评测与策略感知校准,推动了决策模型这一新兴赛道的技术边界。
决策模型的角色:从“生成”到“治理”
生成式模型可以“写”,但面向生产场景,系统需要一个会“管”的大脑:对请求快速分流、判断工具是否可用、识别检索是否可靠、在不确定性可控的前提下决定是否继续深入推理。这类“决策模型”与传统通用大模型的差异在于目标函数与成本意识:
- 目标从“语言流畅”转向“决策正确且可解释”,强调置信度与风险管理。
- 预算从“尽可能思考”转向“按需思考”,强调计算成本与延迟可控。
- 输出从“一个答案”转向“带置信度的结论”,以支撑上层策略调度。
StartLux 的新一代决策模型,在这三点上形成了工程闭环:提供不同规模与思考深度的选择,配套校准机制与评测规范,使“可控的推理”不仅存在于论文中,也能体现在线上服务的 SLA 与成本曲线上。
双路线布局:Instant 与 AutoThink 的分工协作
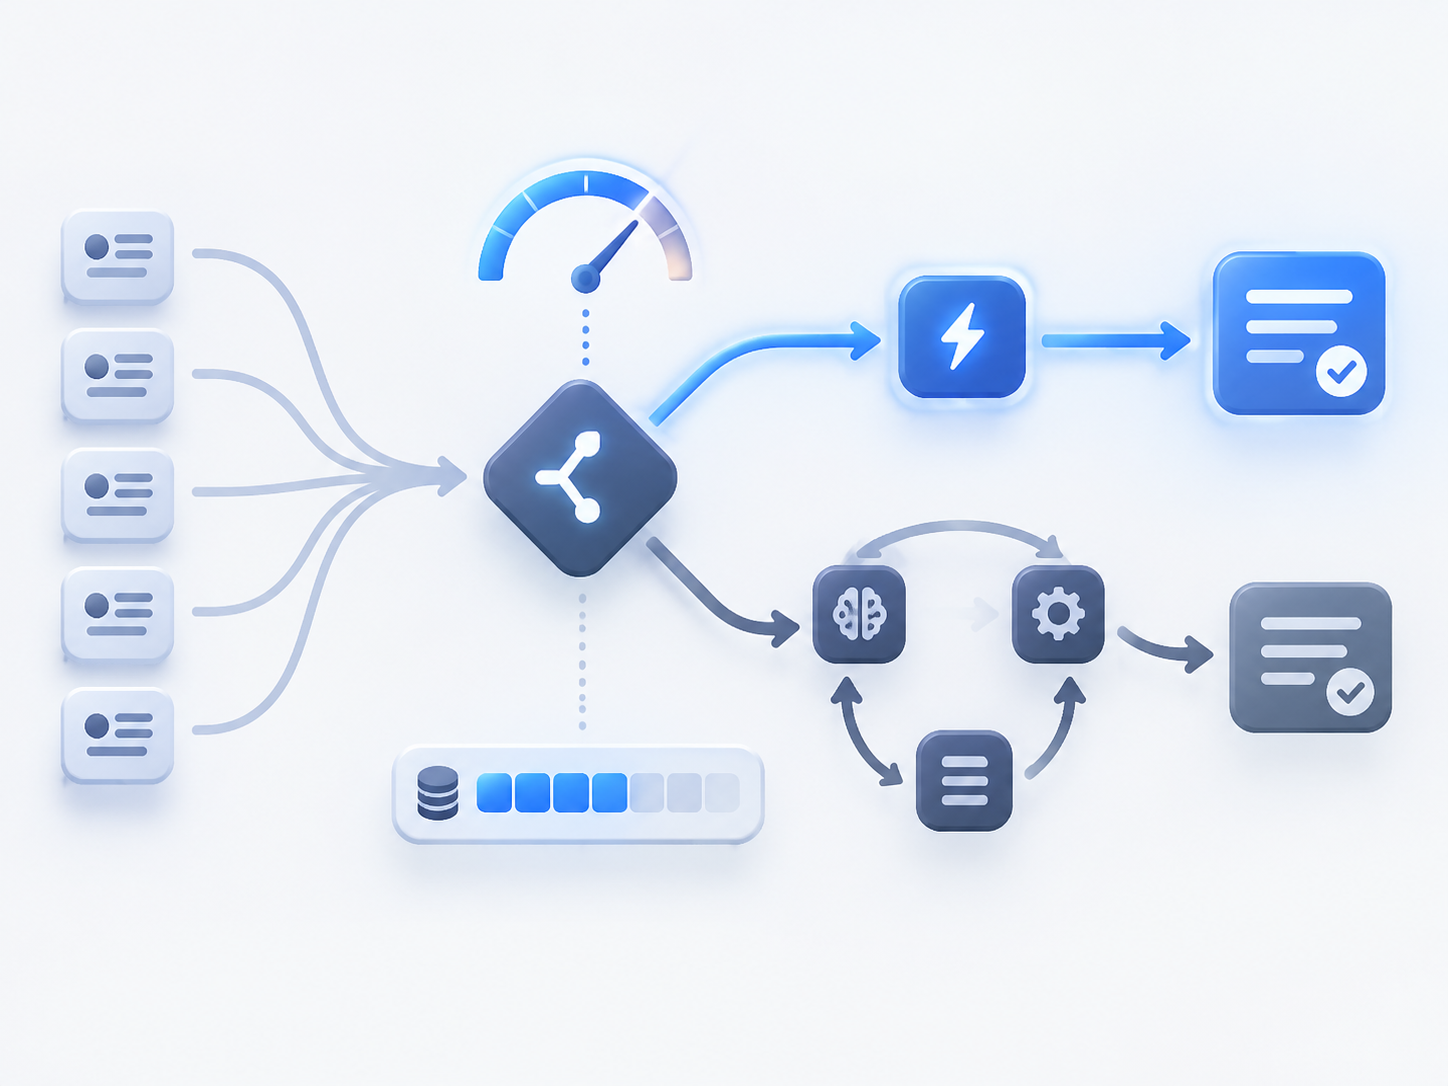
StartLux-Decision 的两条产品线,分别面向“简单题快答”和“难题再细想”的现实约束。
- Instant(极速判断版)
- 规模覆盖 0.8B 至 27B。
- 默认不展开推理链,直接输出答案与置信度。
- 适用高频、延迟敏感场景:请求路由、内容分类、工具选择、风险预审等。
-
优势在于吞吐量与稳定性:让大量“可即时做出稳妥决定”的请求在边缘或服务器侧快速闭环。
-
AutoThink(按需思考版)
- 规模覆盖 4B、9B、27B。
- 默认阈值策略:置信度达到 0.9 即直接回答;若不足,才进一步核对规则、计算数字、排查例外。
- 典型收益体现在临界值判断与复杂规则堆叠,如电商风控与合规模块:当运费从 24.03 变为 24.05、总价跨越 500.84 上限,模型通过加深检查纠正直觉偏差。
这种“先判后思”的设计,本质是把“推理”变成一种受控资源:不是鼓励模型无限展开,而是让它在发现“不够确定”时理性地购买更多计算,接近现实系统中“延迟-成本-正确率”三者的最优折中。
成绩上也体现了这一路线的合理性:在第三方榜单中,27B Instant 以 69.1 分拿到唯一越过 69 分的成绩;在 Decision Index 0.3 的测试中,27B AutoThink 综合得分 73.37,对比同赛道模型(如 Jev hosted 57.96)拉开约 27% 的差距。短短十余天两度刷新行业最佳,这说明 StartLux 把“策略选择”作为一等公民纳入训练与推理流程,而非仅依赖模型体量堆砌。
RLCD²:让推理“花在刀刃上”
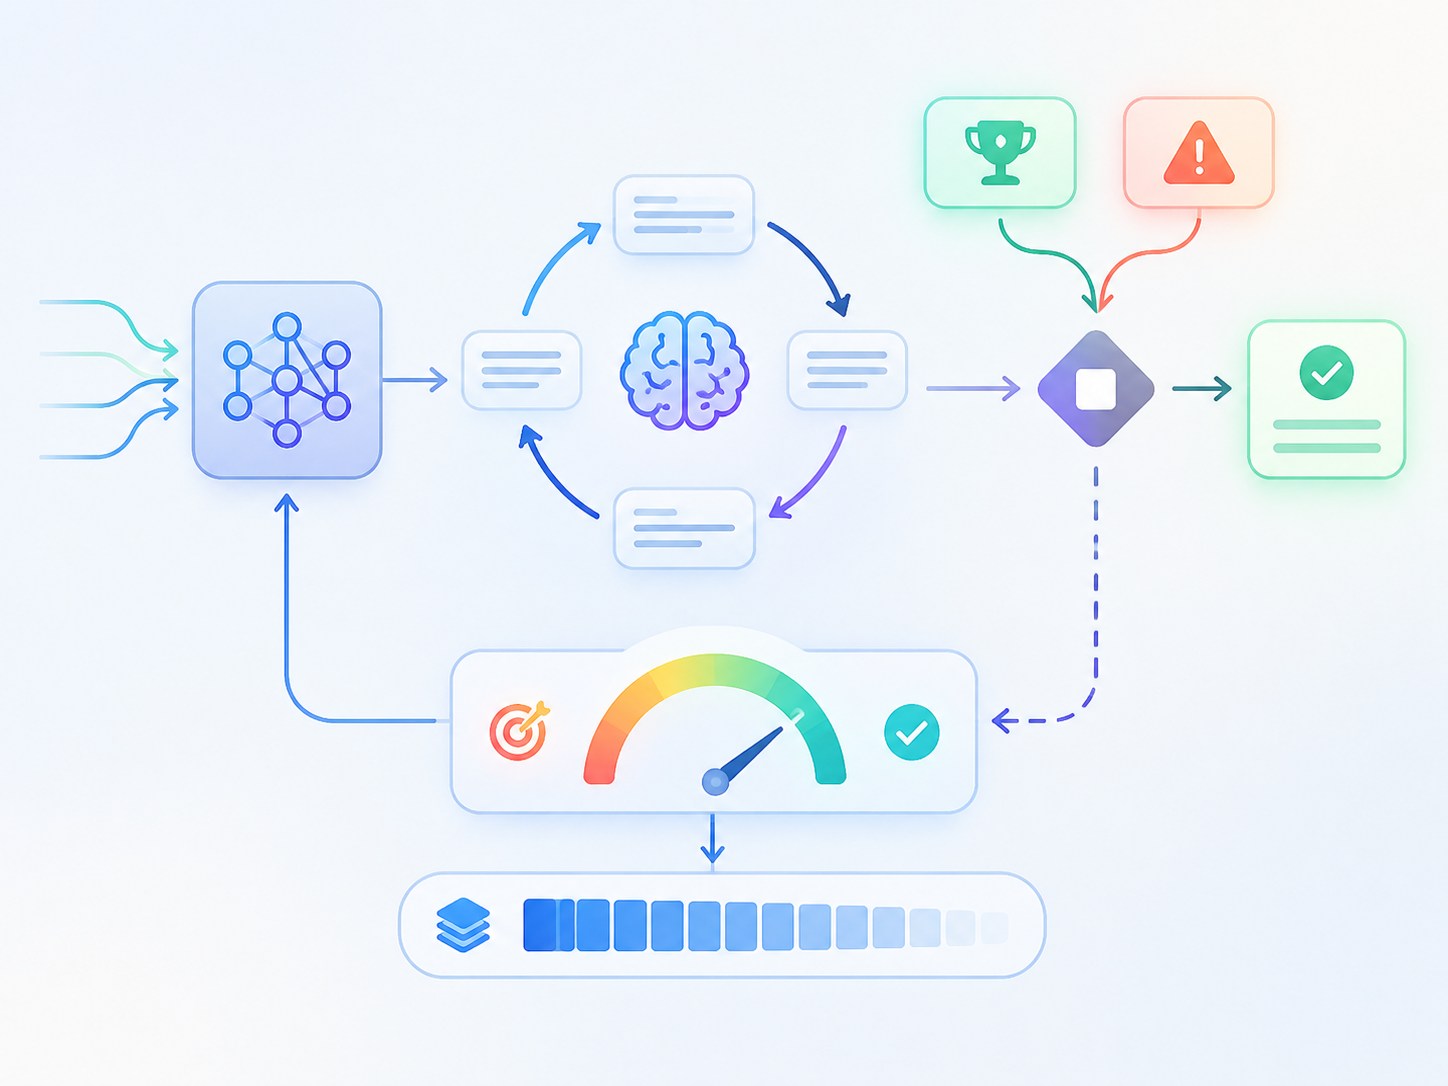
“会想”和“想得其所”是两回事。许多模型在链式思维中陷入冗长自语,既消耗成本,也未必提升正确率。StartLux 提出的 RLCD²(Reinforcement Learning for Calibrated Deliberative Decisions)在强化学习框架下,对“思考是否真正改善判断”进行奖励,对“无效拉长与超预算”进行惩罚,从而训练出具备自我约束的推理行为。
核心要点:
- 校准导向:不仅优化最终准确率,也优化“置信度-正确率”的一致性,降低过度自信或过度谨慎带来的系统风险。
- 成本感知:将推理长度、停止时机纳入策略优化,鼓励在达到有效结论后及时收敛。
- 实证效果:在 9B 模型上,自行结束推理的比例由 45.9% 提升至 93.9%,平均推理长度从 2494 token 降至 868,约 65% 的节省,同时保持决策准确率基本不变。
方法之外,StartLux 还推出 DecisionPivot 评测基准与策略感知校准方法,并展示动态多模态演示,构建出“方法—评测—产品”的闭环。这种闭环的价值在于:把“合理停止”“置信度校准”“策略一致性”这类容易被忽略的工程指标,变成可以衡量与持续优化的公共标准。
成绩的含义:从“分数第一”到“系统能力领先”
连续登顶并非孤立事件。9 月底,StartLux 的 27B 模型在 Decision Index 0.2.1 得分 63.88,领先于 Jev 1.13 的 57.91;新版在 0.3.2 中的 69.1 与 0.3 测试中 AutoThink 的 73.37,显示其从单点超越扩展为全系列领先。对行业而言,这有几层含义:
- 决策模型走向“可用性时代”:具备计算预算管理、置信度输出、策略阈值与自停止能力的模型,进入可生产的技术门槛。
- 智能体堆栈的关键基座:无论是工具调用、RAG 检索校验还是多代理协作,一个可靠的决策中枢能显著降低系统性错误与支出波动。
- 中国团队的话语权提升:在开放社区的权威榜单上持续领先,说明不仅在模型规模上追平,更在“方法+工程”层面形成自主优势。
- 也需保持清醒:榜单是强信号,但非全部真相。真实场景的噪声、对抗性输入与长尾任务,仍然需要更广泛的压力测试与落地验证。
影响与展望
决策模型的崛起,正在重塑 AI 系统的设计范式。面向开发者与产品团队,几条务实的建议值得参考:
- 采用双阶段推理:以 Instant 承载 70%-90% 的高频请求,在置信度低或规则复杂时回退到 AutoThink。
- 管理计算预算:将“推理 token 上限、延迟目标、成本上限”合并成策略参数,动态调度资源。
- 做好校准与监控:上线前用可靠的评测(如 DecisionPivot)对 ECE(期望校准误差)与停机策略做回归,线上以置信度分布与错误分布做 A/B 追踪。
- 嵌入安全与合规:利用带置信度的拒答与规则核查流程,在内容风控、金融合规、医疗建议等高风险场景降低系统性风险。
- 设备端与本地化:小尺寸 Instant 为边缘与本地智能提供可能,结合 AutoThink 的云端回退,构建“端云协同”的弹性架构。
展望未来,决策模型将与工具生态、检索增强、规划执行进一步融合,演化为“分层控制器”:上层负责策略与资源分配,下层负责细粒度推理与执行。多模态决策(文本—视觉—结构化数据)的统一校准、跨域泛化与对抗鲁棒性,会成为下一阶段的竞争点。与此同时,行业也需要警惕“过度优化榜单”的偏差,持续推动更贴近实务的公开评测与长周期稳定性验证。
当 AI 从生成跃迁至执行,决策能力就是系统的“骨架”。StartLux 此次连番领跑,折射出一个趋势:在成本、置信度与策略一致性这三根支柱上,优秀的工程与方法创新可以让智能体真正从“会说”走向“会做”。
标签: 决策模型 RLCD² 智能体 HuggingFace 中国AI
还没有评论
发表评论