引言
国产大模型的竞争正悄然下沉到“看不见”的底层:算子。一个模型的速度、成本与能耗,最终都取决于在特定芯片上,核心算子(GEMM、注意力、归一化等)被执行得有多高效。换一套更优的算子,同样的模型、同样的显卡,吞吐就可能倍增,单价也会立刻降低。
这一周里,发生了两件值得记录的事:DeepSeek 开源了完整的推理链路 DeepInfer,把 FlashMLA、DeepGEMM 等看家本事一并交了出来;同时,一个完全由 AI 自动编写、无人工逐行调参的 ForgeKernel,在英伟达与昇腾两大阵地的权威评测中双榜登顶,基准加速比达 1.835×,领先第二名 25%。人类工程师把算子性能推到硬件极限的九成,AI 则在同一周进一步刷新了上限。
核心内容
为什么“算子”决定了速度与价格
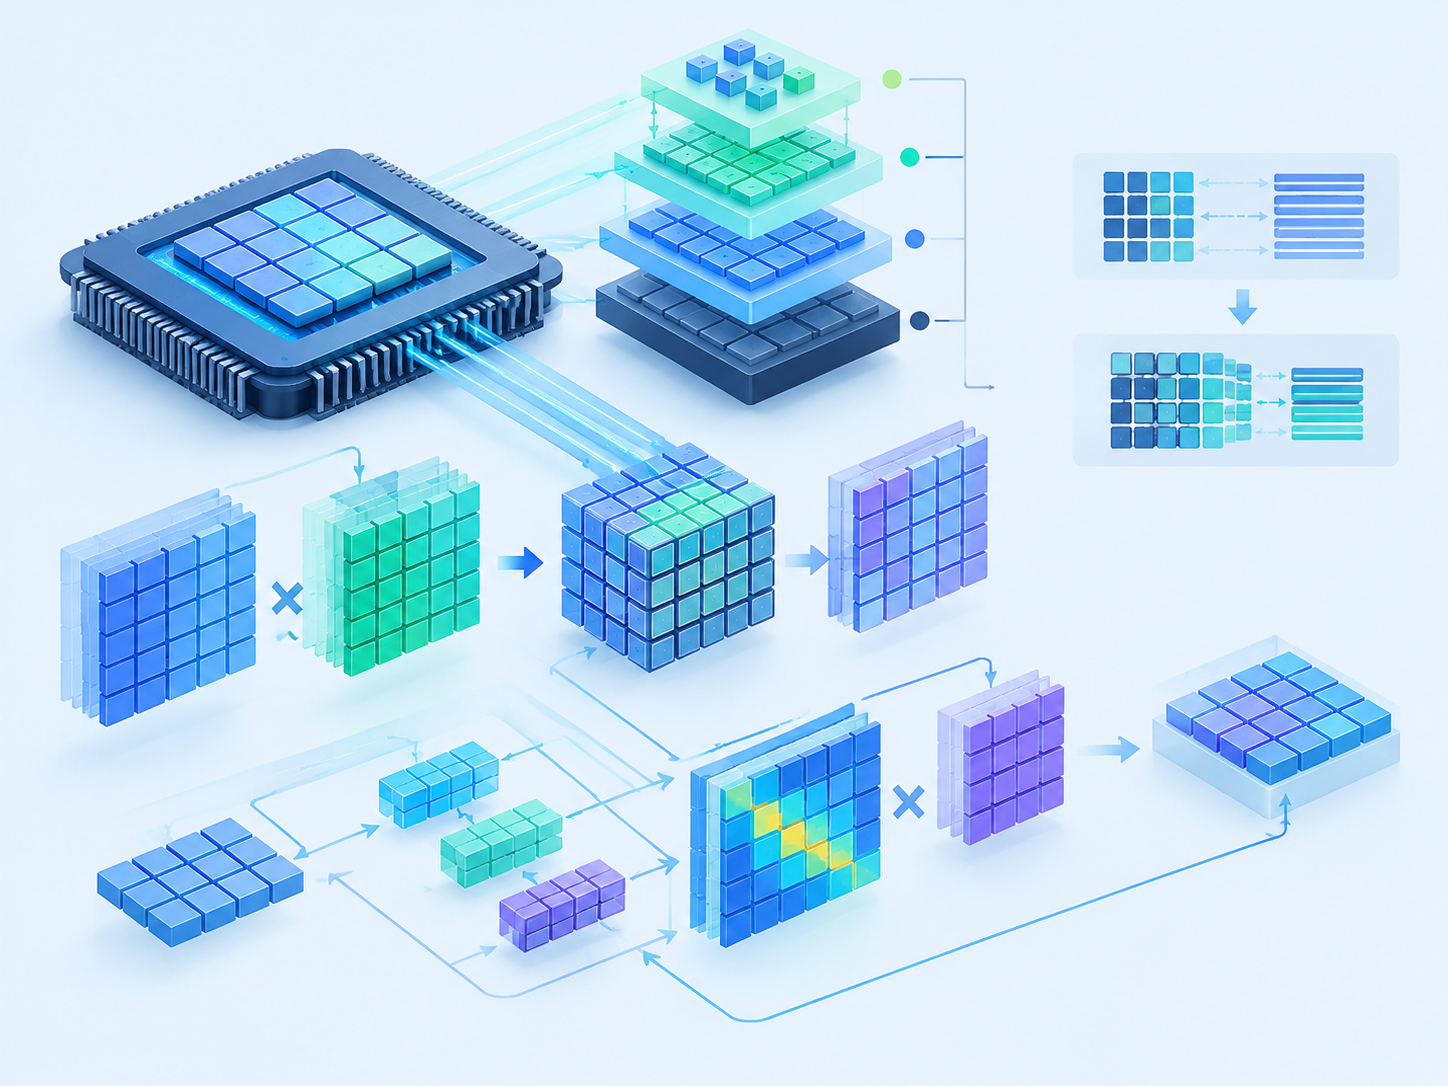
在深度学习的执行栈里,模型只是“配方”,算子才是“烹饪”。推理时最耗时的模块,往往集中在少数几个算子上:
- 矩阵乘(GEMM/MatMul):吞吐与寄存器、共享内存、TensorCore 利用率直接挂钩;
- 注意力(Flash/MLA 类):本质是计算与访存之间的复杂权衡,通过块化、重排减少内存往返;
- 激活、归一化、残差融合:内存带宽敏感,靠算子融合减少访存次数。
对这些热点算子进行极致优化,带来的不只是“跑得快”。它还会重构推理经济学:
- 同一块卡,TPS/TPM 提升意味着单位算力产出更高;
- 每 token 成本随之下降,服务价格空间更大;
- 延迟下降带动交互体验提升,尤其在长上下文与多 Agent 场景。
因此,谁掌握高效算子,谁就掌握了推理成本的“费率表”。
DeepSeek 的开源链路与“手工极限”
DeepSeek 此次开源的 DeepInfer,不只是把模型权重公开,而是将模型运行的全链路推演出来:从高层图到特定芯片的低层算子,通过 FlashMLA、DeepGEMM 等库,尽可能把硬件“榨干”。其中一版 FlashMLA 在部分芯片上由工程师逐行手调,性能逼近硬件极限的 90% 以上,这几乎是传统手工优化的“天花板”:要同时解决
- 内核参数(tile 尺寸、并行策略)与寄存器压力的精妙平衡;
- L2/L1/共享内存的数据复用;
- 指令调度与流水深度控制,避免流水暂停;
- 数值稳定性与精度模式下的误差传播。
这种成绩的价值,在于它提供了一个“可复用的上限参考”。开源让更多团队在此基准上快速迭代,而不是从零开始重复造轮子。
AI 写算子:ForgeKernel 的方法与成绩
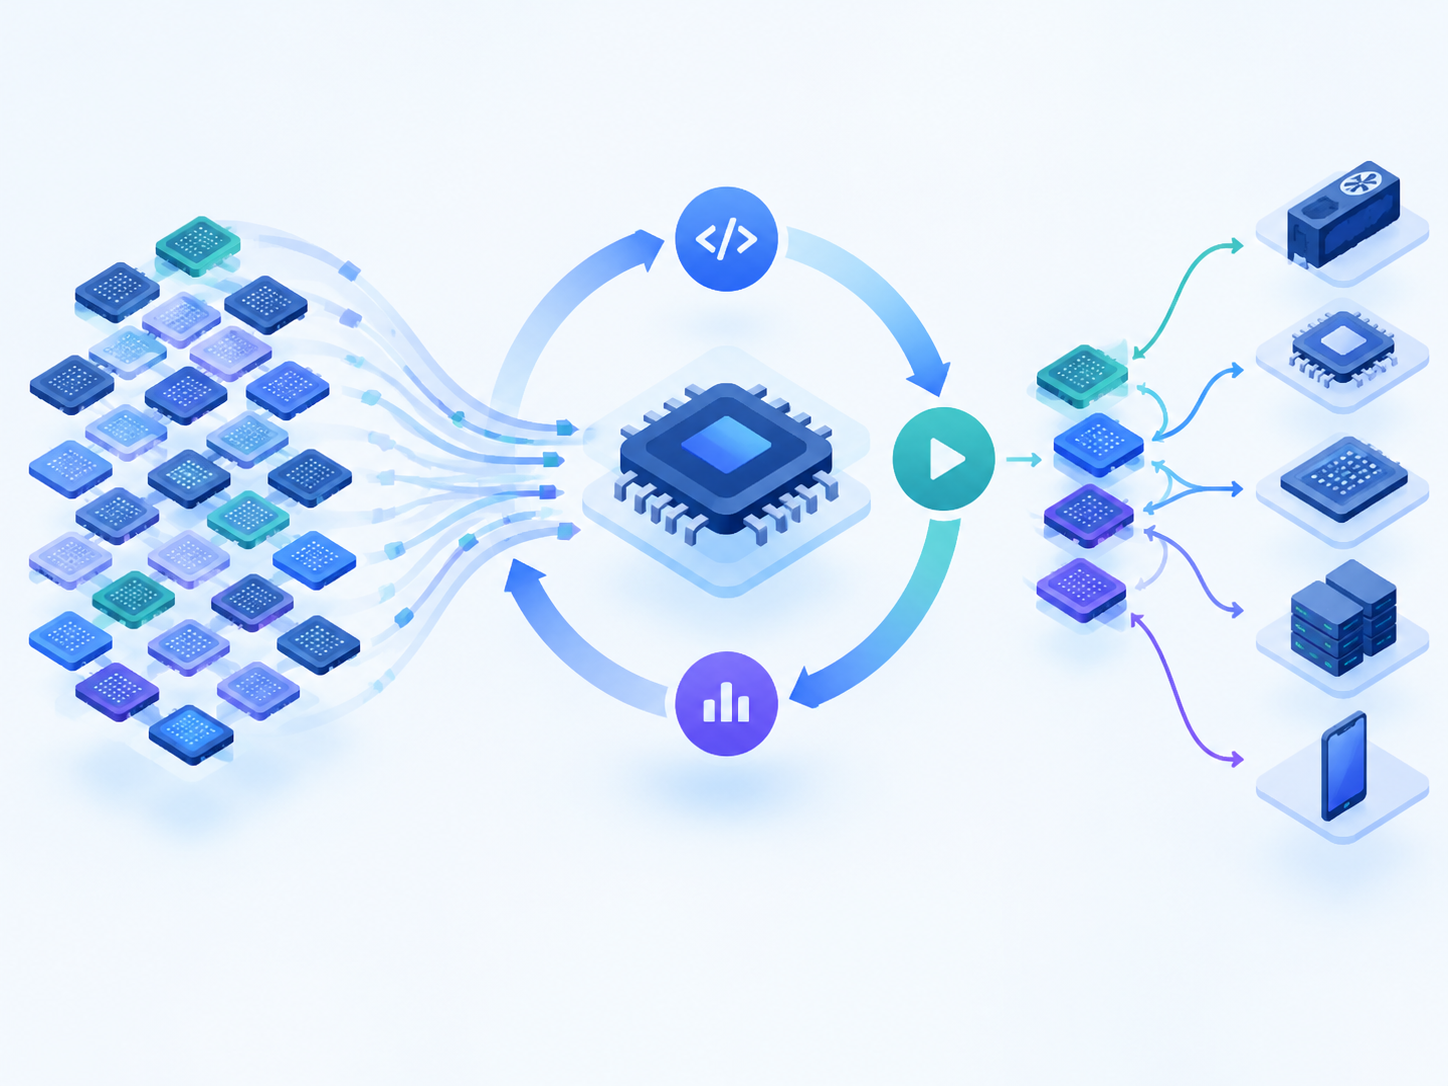
更具冲击力的是,完全由 AI 生成、无人工逐行调优的 ForgeKernel 在两大评测中夺冠:
- 英伟达主场的 SOL-ExecBench 与 FlashInfer-Bench 合集;
- 昇腾官方维护的 CANNBench A3 硬件榜。
公开信息显示,其基准加速比达到 1.835×,领先第二名 25%。更重要的是,它在 DeepSeek v4.1 Flash 的同类算子上,通过“从零开始、AI 迭代”的方式,超过了 DeepSeek 开源的英伟达版本。
这类系统通常具备以下特征(以通用方法论理解):
- 大规模候选内核生成:利用代码生成模型,快速产出成百上千种调度与内核变体;
- 自动搜索与反馈:通过编译-运行-采样的闭环,基于实际吞吐、延迟与访存计数进行排名;
- 约束注入:对寄存器压力、共享内存占用、占用率(occupancy)设定上限,避免“跑不起来的快内核”;
- 多芯片后端:面向 CUDA、Ascend TBE/CANN 等不同生态,内置适配与形状泛化策略。
这意味着,AI 不只是“会写代码”,而是在算子层面进入了可以与资深工程师同台竞技的阶段。而且,双榜登顶指向一个严肃事实:AI 自动优化不再局限于某一家硬件或单一基准,具备跨平台迁移的可行性。
从英伟达到昇腾:跨生态突破的信号
以往的优化往往深度绑定某一平台。此次同时拿下英伟达与昇腾榜单,传递出三点信号:
- 算子搜索的“共性”存在:在不同 ISA 与内存层级结构下,依然有可迁移的调度策略;
- 国产芯片受益显著:高效算子缩小了生态差距,提升了在大模型推理市场的竞争力;
- 基准驱动的良性竞争:公开榜单让优化透明可比,形成面向应用的绩效指标,推动厂商与社区持续改进。
这对推理平台方同样重要:同一模型在不同硬件上保持稳定的性能曲线,更容易实现多云与多芯片调度策略,减少被单一供应商锁定的风险。
影响与展望
算子层的开源与 AI 自动优化,正在重塑推理栈的分工与边界。可以预见的变化包括:
- 工程效率跃迁:从“专家手工 + 试错”转向“AI 搜索 + 专家约束”,人类关注正确性、稳定性与跨平台策略,AI 承担海量变体探索。
- 成本下行加速:当热点算子持续逼近硬件上限,推理成本曲线会进一步下探,长上下文与多模型流水线的门槛降低。
- 国产算力崛起:跨生态的优胜成绩,意味着在昇腾等国产平台上,模型服务可获得与国际主流生态相近甚至更优的每瓦性能。
- 开源生态强化:DeepInfer 的开放,加上社区榜单的“可验证性”,会让优化成果更快进入主干,减少重复劳动。
同时,也需要正视几项挑战:
- 基准过拟合风险:对特定形状或序列长度的微调可能在真实负载下“失速”,需要更广覆盖的工作负载与随机化测试。
- 正确性与数值稳定:尤其在混合精度与长序列场景,微小的算子差异可能放大为输出偏差,必须引入系统性的验证基准。
- 可维护性与可移植性:AI 自动生成的内核需要更好的可读性与注释规范,否则在驱动、编译器升级时难以及时修复。
- 系统级优化的协同:算子层的极限并不等于系统极限,图层融合、KV 缓存策略、异步流水与通信重叠同样关键。
更长远看,算子优化会从“单核竞技”走向“自动化编译的军备竞赛”:以 AI 为内核的编译器/调度器,结合硬件计数器与能耗模型,形成持续进化的性能闭环。对开发者来说,最务实的路径是双轨并进——拥抱开源链路与 AI 自动化,同时保留对关键路径的工程把关;对产业而言,这种“智能接力”将让每一块芯片更快、更省、更可依赖。
当模型创新与算力创新不再割裂,推理效率的天花板还会被一次次抬高。国产智能要想在全球范围内具备可持续的服务能力,唯有在算子与系统层面把“速度与成本”的基本功练到极致。DeepSeek 的开源与 ForgeKernel 的登顶,正是这条路上的两束强光。
标签: DeepSeek 算子优化 推理加速 AI编译 国产算力
还没有评论
发表评论