引言
大模型正在离开纯文本的“聊天框”,进入充满噪声、多人、设备协同的真实世界。语音,正成为这一转变的关键入口。科大讯飞在 10 月 22 日集中发布新一代人机交互技术:面向声音理解的 SparkAudio 1.0,以及端云一体的星火 X2.6 与端侧模型 Spark-X2.6-4B。平台数据显示,语音大模型相关调用量同比暴涨 20 倍,部分端侧方案已实现约 70% 的云端能力。这不仅意味着“能说会答”,更标志着从“听清一句话”走向“听懂现场发生了什么”。
SparkAudio 1.0:从语音转写到声音场景理解
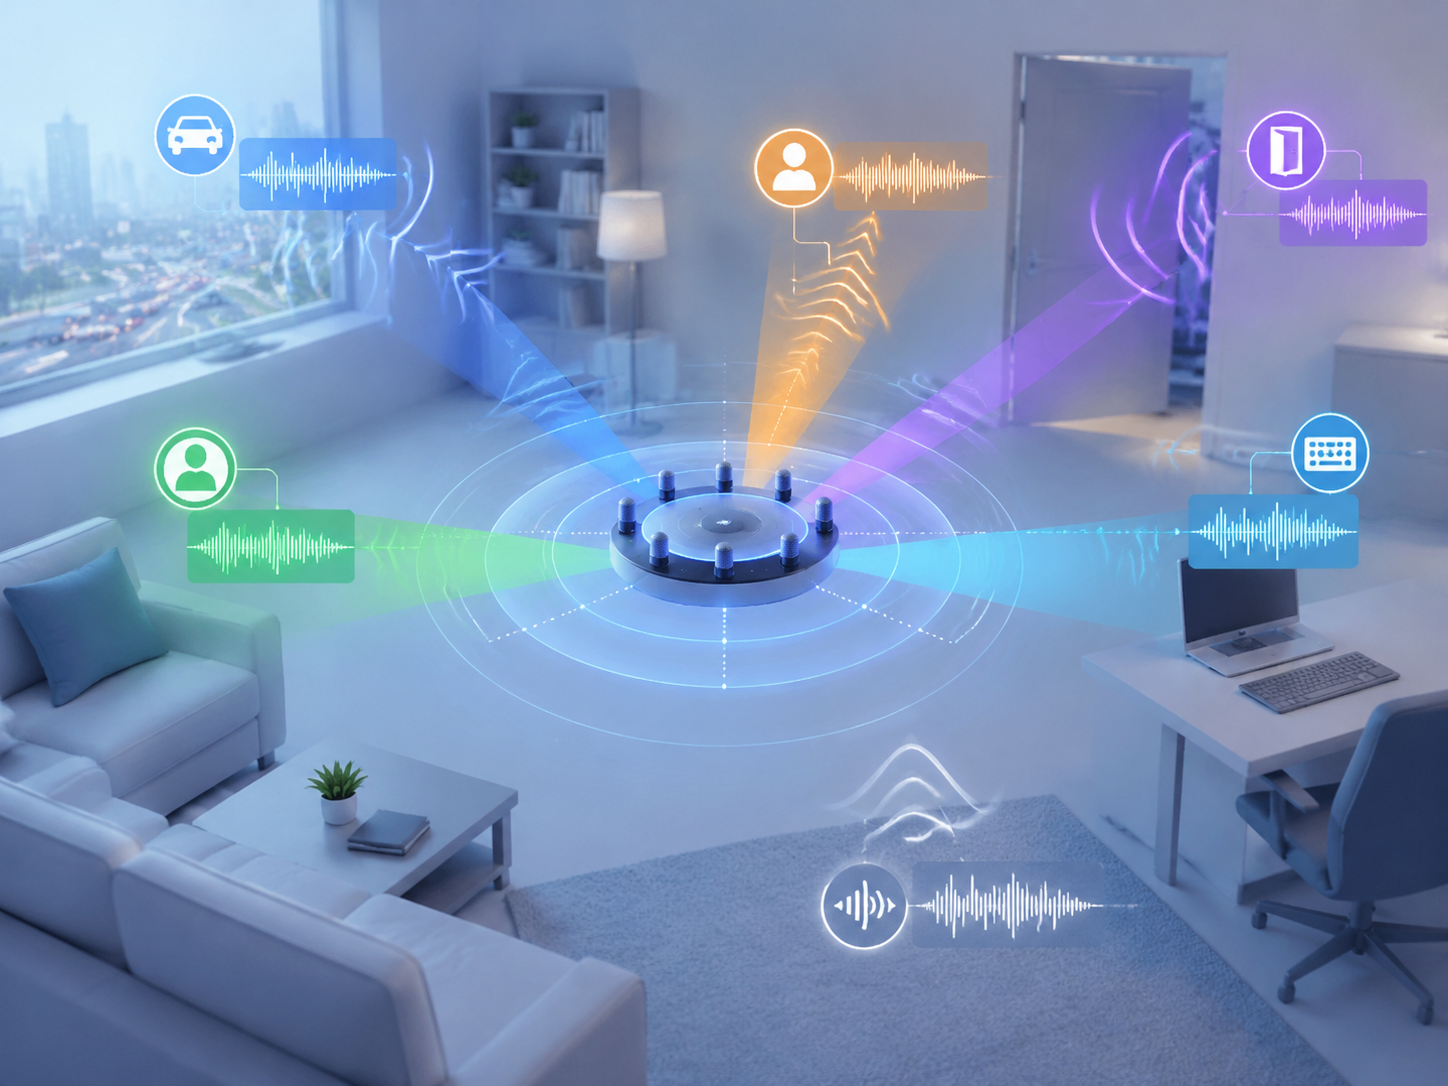
传统语音系统多采用级联架构:降噪→ASR→文本理解→TTS。流程清晰,但不可避免地丢失大量“非文本信息”,例如说话人的情绪、语气、身份、空间位置、是否被打断,以及环境声线索。这些恰恰是现实交互中决定意图与优先级的关键信号。
SparkAudio 1.0 的发力点,是把过去分散在多模块的声学与语义能力统一进一个基座模型:在具备识别、同传与交互的基础上,进一步面向复杂音频理解、情绪识别、实时说话人分离、环境声理解等任务。对于多人对话与嘈杂环境,系统需要回答三个核心问题:谁在说、从哪边说、该先回应谁。只有把“声音本身的信息”和“语言内容”一起纳入建模,AI 才能从“转文字”升级为“懂现场”。目前,相关能力已落地输入法、会议记录与办公本等产品,表明其可用性进入生产阶段。
Spark-X2.6-4B:把更多智能搬到本地
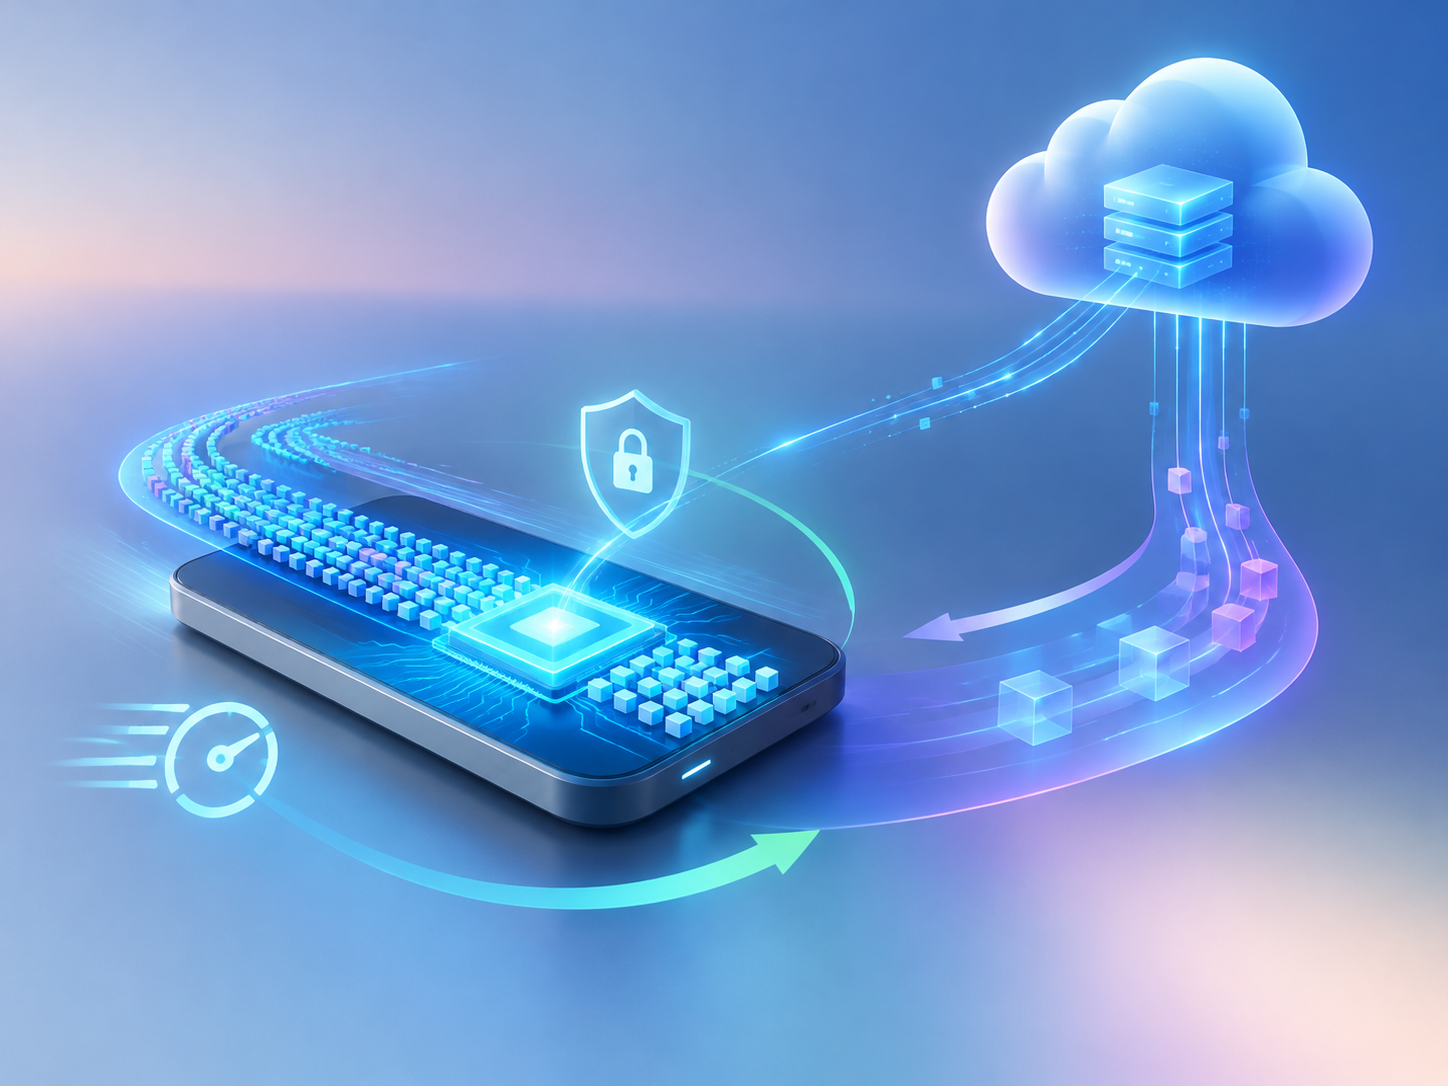
在通用智能层面,讯飞走的是端云一体路线:云端星火 X2.6 处理高复杂度任务,端侧 Spark-X2.6-4B 承担本地推理。值得注意的两个指标:约 41 亿参数、最长约 100 万 Token 上下文。百万级上下文能力下,端侧不仅能做唤醒与简单问答,还能执行长文档理解、工具调用与 Agent 级任务,覆盖更多离线与隐私敏感场景。
这背后有重要工程与商业收益:
- 低时延与高可用:关键交互留在本地,弱网或离线仍可用。
- 隐私与合规:敏感数据不出端,降低数据传输风险。
- 成本与扩展性:高频、简单任务本地化,云端算力压力显著下降。
官方判断的任务划分是“本地约 60%,端云协同约 30%,云端高复杂度约 10%”。当前部分端侧方案已达到约 70% 云端能力,这意味着产品形态将转向“端侧优先、云端增强”的新常态。
让模型理解“声学空间”
真实世界的人机交互并非只关语言。面对“鸡尾酒会问题”,单纯依赖麦克风阵列或唇动视觉都有局限:光线、角度、是否面对摄像头都会影响效果。此次,讯飞把全景摄像头与环形麦克风阵列结合,使系统能在 360 度空间内做声源定位、说话人跟踪与分离。披露数据指向两点:多人同时聊天时串扰率可降至 1.7% 以下;最多支持 5 人实时交互。这对展厅、会议、车舱与公共服务终端尤为关键,因为对话管理、轮次切换与指令定向不再“混线”。
当然,空间多模态也带来新的工程挑战:跨设备的时钟同步、阵列布局差异、计算能耗与散热、以及视觉不稳定性下的鲁棒融合。能否在不同硬件形态上复现稳定的空间理解,将成为下一阶段竞争点。
影响与展望
语音与空间智能的叠加,正在重塑智能硬件的人机界面与产品逻辑:
- 在车内、家居、机器人与政务终端,交互从“单人对话”升级为“多主体、强上下文、低时延”的协作模式。
- 评测指标也随之迁移:从识别准确率,扩展到场景理解准确率、轮次管理时延、隐私边界控制与端云切换体验。
- 端侧智能的提升,直接影响商业模型:云成本下降、敏感场景可落地、服务稳定性提高,同时也要求更强的本地安全与资源管理。
展望未来 12-24 个月:
- 4B 级、百万上下文的端侧模型将成为中高端设备的“标配能力”。
- 语音优先的智能体将具备更强的记忆与工具调用,承担日程管理、会议助理、设备编排等复合任务。
- 多设备协同与空间语义地图将走向普及,形成“房间级/车舱级”的交互中枢。
- 行业将需要统一的空间交互评测与隐私合规标准,推动规模化落地。
从“能听清”到“能听懂”,再到“能协同”,语音大模型正在把真实世界的复杂性引入模型本体。这既是技术跃迁,也是产品范式的更替。
标签: 语音大模型 端云一体 多模态交互 端侧AI 智能硬件
还没有评论
发表评论