引言
当“一个人训练大模型”从段子变成实验结果,行业的生产方式似乎来到一个临界点。硅谷初创公司 Mirendil 宣称:在三个半月内、投入不足千万美元,由一名研究员带着一群 Agent,从零搭建起完整的预训练栈,训练出定位于“编码专用”的百亿到千亿级基座模型,并在部分代码交叉熵指标上逼近头部模型。这不是“省略号式”的宏大叙事,而是对大模型研发流程的一次重构:把99%的工程与试错交给 Agent,人类只做方向、判断与制动。
一个人如何撬动千亿参数
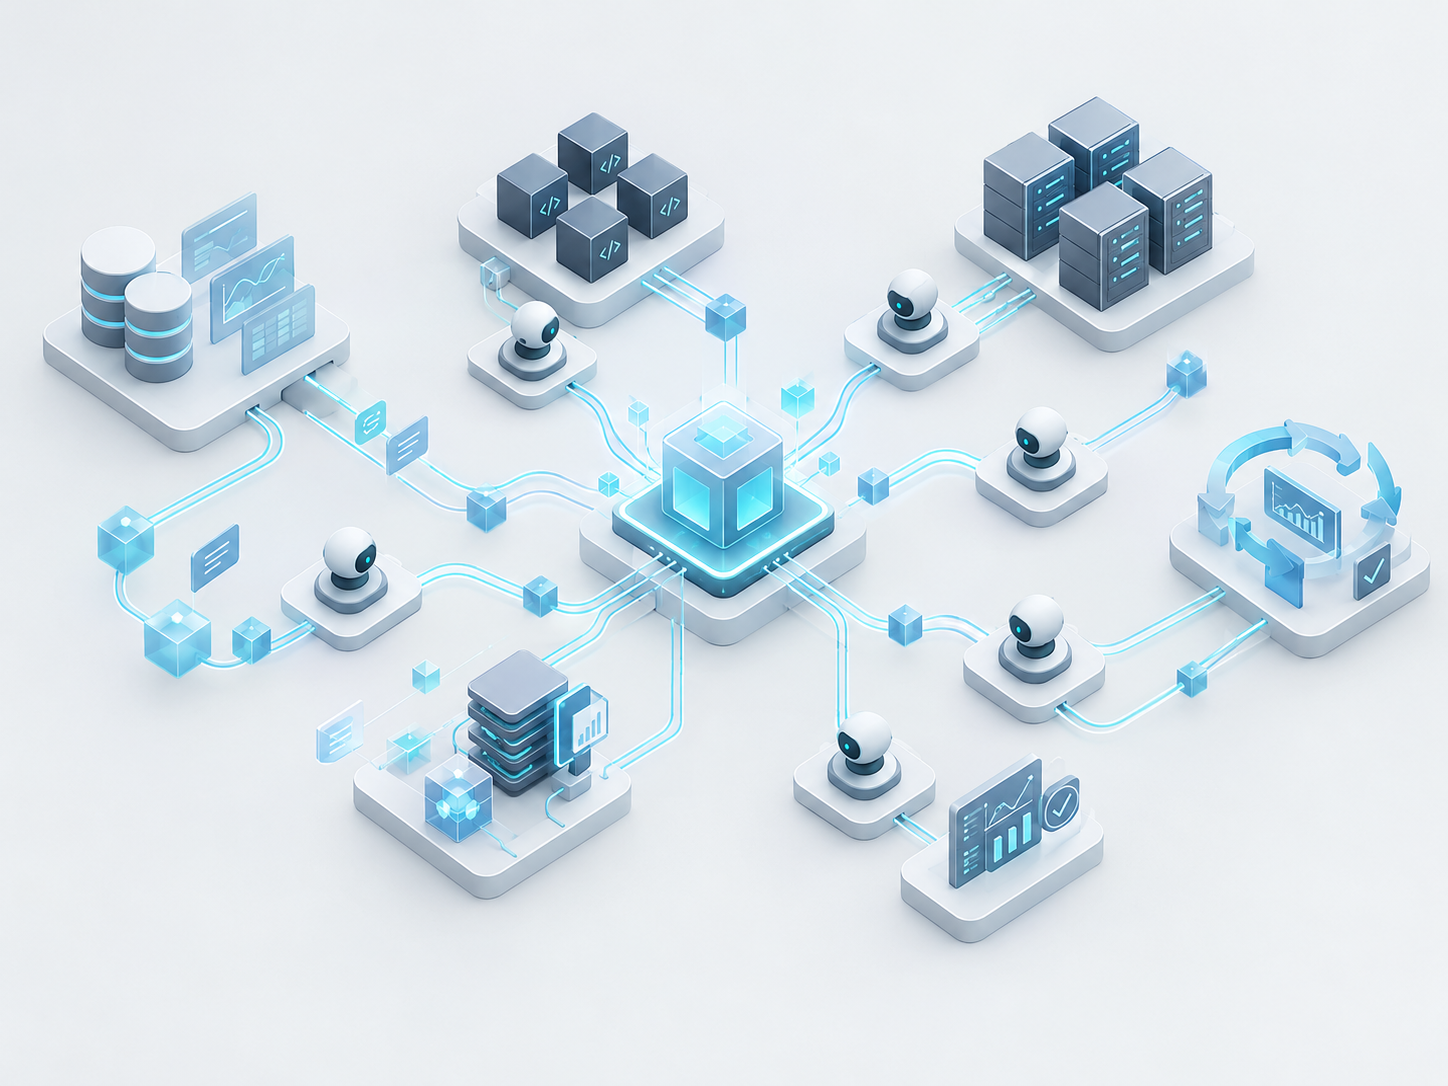
Mirendil 的关键不是“超人类体力”,而是“超自动化流水线”。
-
研发自动化:不沿用现成预训练框架,不继承旧代码,几乎全部组件由 Agent 生成与迭代。人类研究员负责设定目标、选择路线、在关键节点介入;代码撰写、实验发起、日志诊断、错误回滚与参数搜索由 Agent 主导。这相当于用多智能体把“大厂人海战术”折叠成可编排的编程流水线。
-
从零到一的训练栈:在通用库(如 PyTorch、JAX)之上重搭模型架构、数据管道、训练调度与评测基线。基础设施写作与运维自动化,降低了“组织复杂度成本”,让个体也能驱动复杂工程。
-
数据策略:仅用公开数据(开源代码、网页与公开数据集),不购买数据、不做蒸馏、不用合成数据。这在版权与合规上更可控,但也意味着需要更精细的数据清洗、去重、分布混合与质检流程,Agent 正好擅长这类“可编程的脏活累活”。
-
效率工程:通过改进架构与数据混合、高级调优,以及内核优化(如算子融合、内存访问模式优化等),把训练成本“硬拗”到可承受范围。大概率采用了 MoE(专家混合)路线,使得激活参数远小于总参数,单位 token 计算开销更低,训练可“以小搏大”。
-
成本结构:不到千万美元覆盖了 Agent 的 token 开销、数据处理与全部实验。这类成本配置意味着算力采购、实验并发、失败容忍度都被精打细算;更重要的是,Agent 把“人时成本”转化为“算力+token 成本”,换了个维度降本增效。
指标该如何解读
官方给出的强项是代码领域的交叉熵评测:在某新代码仓的 next-token 预测中,Mirendil-Base 与头部模型同台较量。值得注意的有三点:
1) 基座 vs 后训练:常见现象是“基座模型在交叉熵更占优,后训练模型在下游任务更强”。因此,Mirendil-Base 逼近某些后训练成品的分数,并不意味着综合能力持平,后者真实实力往往被该指标低估。
2) 任务域偏置:这是“编码专用”基座,擅长代码建模并不自动外溢到通用语言、检索增强、对齐安全或工具使用的综合能力。若要进入产品化阶段,还需指令微调、偏好对齐、工具链接入与安全红队的系统工作。
3) 尺度延展:其 Large(5000亿-2万亿)与 XL(2万亿-10万亿)版本仍在训练,早期进展显示“更大规模+更好数据混合”带来更快的指标追平。这印证了 scaling law 在特定域内的延续性,但最终效果仍取决于训练长跑中的稳定性与样本效率。
为什么这次能成立
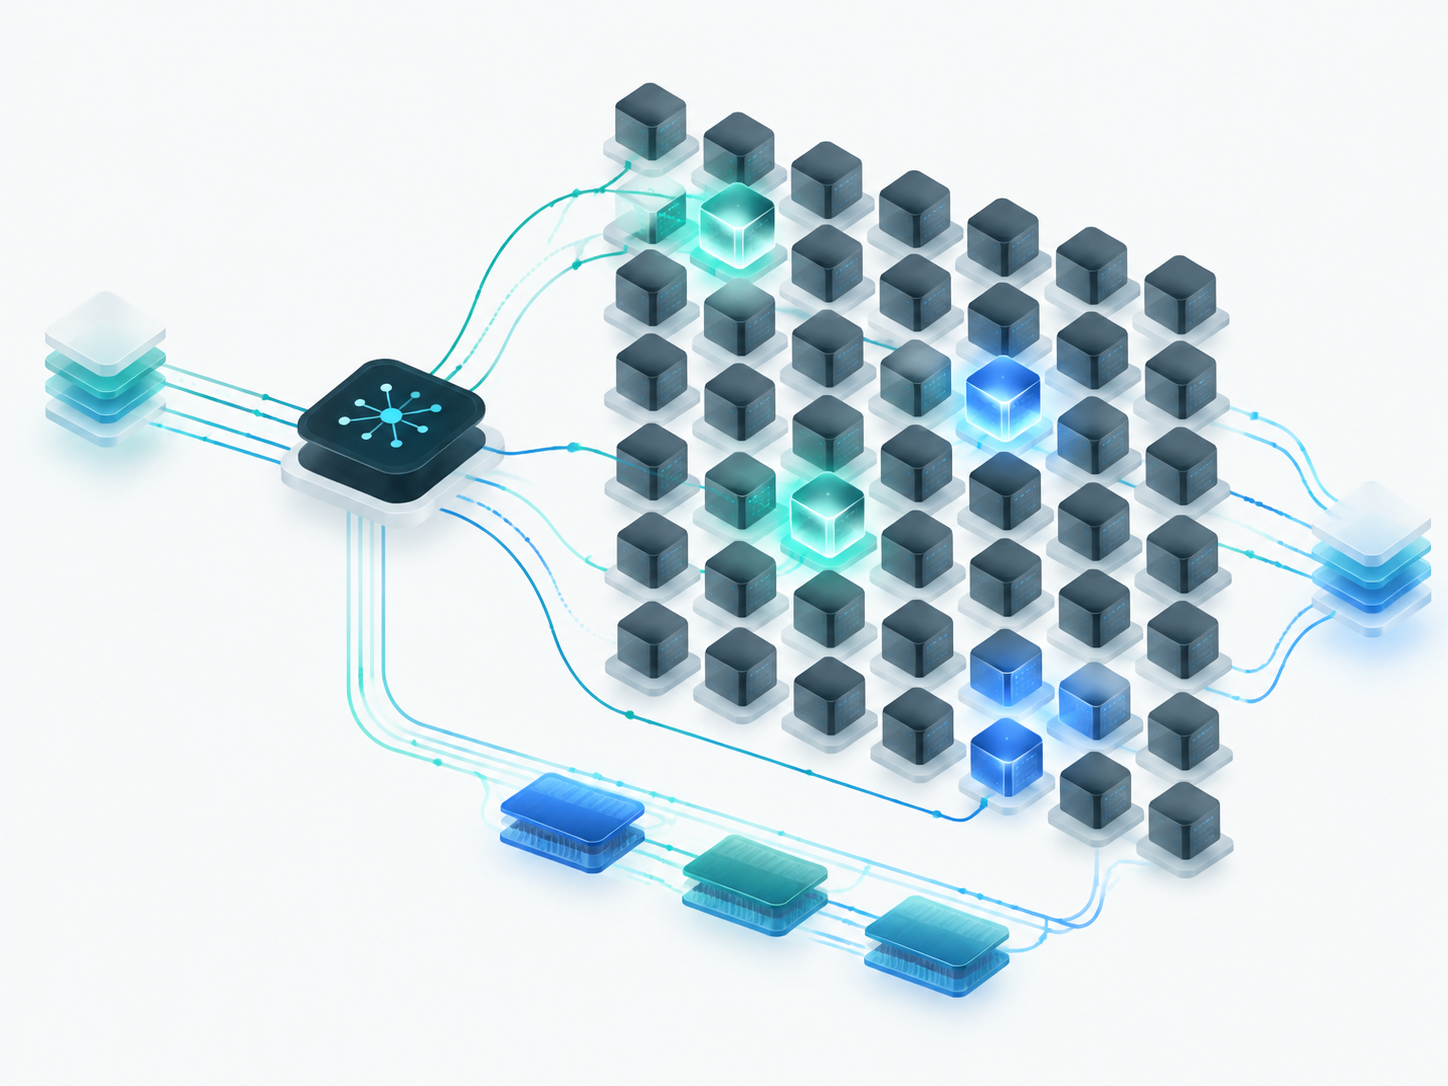
把过去“只能由大厂完成”的项目压缩到个人+Agent,背后是三股合力:
-
工程自动化的临界成熟:多智能体能够稳定地拆解任务、生成可运行代码、回溯错误并做批量实验,形成“研究-工程-评测-迭代”的自循环。人类负责建立“信任与约束”的边界条件,避免 Agent 走偏。
-
架构与算力的效率红利:以 MoE 为代表的稀疏化架构,叠加内核级优化,让“可训练的总参数”与“单位 token 的实际计算”脱钩,降低了冲击百亿、千亿量级的门槛。
-
数据工程的流程化:公开数据的可得性与可控性配合 Agent 的程序化过滤、混合、去重与质量评估,让“没有私有语料、没有蒸馏”也能达到可观的基座质量。
仍需冷静:边界与风险
-
评测覆盖不足:代码交叉熵只是切面之一,通用理解、长上下文、工具使用、鲁棒性与安全性都需要系统化测评。单一指标“看起来接近”,不等于系统能力“真正接近”。
-
自动化技术债:当99%代码由 Agent 生成,测试覆盖率、可维护性、可解释性与回归防护变得尤为关键。没有强约束的自动化迭代,容易叠加“隐性复杂度”,形成后期难以偿还的工程债。
-
数据与合规:只用公开数据并不天然等于零风险,License 兼容性、内容安全与个人信息泄露等问题依然需要治理流程与审计证据链。
-
可复现性与稳定性:从零搭的训练栈若缺乏严谨的配置与版本管理,复现实验结论可能代价高昂。小团队要“把自动化做成产品”,离不开工具链与流程标准化。
-
对齐与产品化缺口:没有蒸馏与偏好对齐的基座,很难直接进入用户场景。真正难的不是“能训起来”,而是“能安全、稳定、低延迟地服务”。
影响与展望
Mirendil 的示范不是“奇观”,而是范式:用 Agent 把大模型研发重构为可编排的自动化流水线,让过去需要几十到上百人的工作,被一名研究员在短周期内完成。对行业的潜在影响包括:
-
创业门槛下移:小团队有机会在垂直领域(如代码、金融文本、医疗文献)自建高质量基座,形成差异化护城河,不必一开始就依赖巨头模型。
-
组织形态变化:从“人海战术”走向“人类研究员+智能体军团”,研发岗位更像“编排者”和“评估者”。最稀缺的能力将从“手写最优代码”转向“设计目标函数、评测体系与安全策略”。
-
工具链生态崛起:自动化数据工程、训练调度、评测与对齐的一体化平台将成为新基础设施。谁能把“AI 训练 AI”做成标准产品,谁就握住新的生产力杠杆。
-
安全与治理前置:当训练与迭代速度大幅提升,红队、评估基准、合规审计与可追溯性需要与算力同频扩张,否则风险会以同样速度被放大。
从“能训出一个体量可观的基座”,到“能产出经得起大规模应用的产品”,中间仍隔着对齐、安全与工程化的鸿沟。但可以确定的是,单人带队的 Agent-first 研发范式已经实打实地撬开了门。接下来,谁能把这扇门后面的流程标准化、成本可预期化、风险可治理化,谁就将定义大模型生产的下一条主航道。
标签: 大模型训练 AI Agent MoE 自动化研发 模型评测
还没有评论
发表评论