引言
ACM Multimedia(ACM MM)走过33年,在今年前夕完成了一次看似“分类学”的调整:把原来的五大主题、15个子方向,改为16个平级研究主题。乍看只是目录换了一版,实则是在给多媒体研究的边界重新划线。随着生成式AI、基础模型与具身智能的快速融合,多媒体已经不止是“图像、音频、视频的处理”,而是延伸到感知—推理—行动的完整闭环。
新增“具身与沉浸式多媒体”和“多媒体推理”
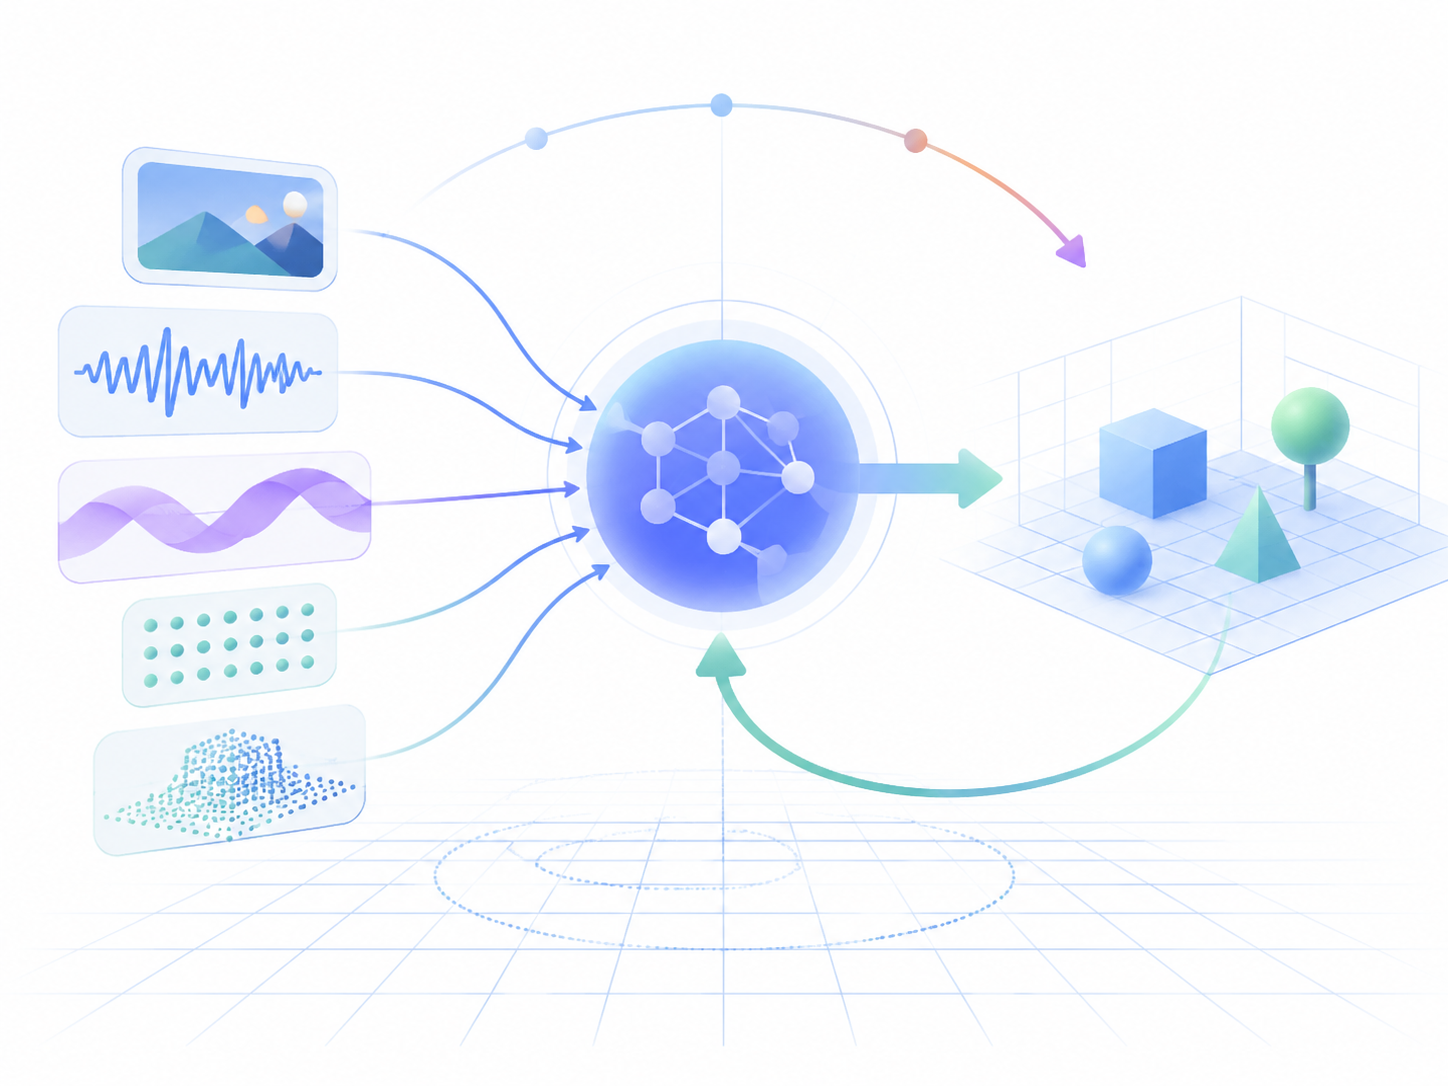
两个新设的独立主题,变化最为醒目:
- 具身与沉浸式多媒体:强调能在真实世界感知、行动与交互的智能体,以及视觉、语言、音频、触觉等模态的整合。关键点不是机器人硬件,而是多模态信号与决策的耦合——把“看见什么”与“如何行动”连接起来。
- 多媒体推理:突出时间、空间、因果与逻辑层面的跨模态推理。模型不只回答“发生了什么”,更要解释“为何发生”“线索如何关联”“画面之外能否合理补全”。
这背后反映出两层趋势:其一,多媒体研究从“内容理解”走向“世界模型与决策”;其二,学界希望将“理解中的推理”显式化,形成可比较、可评测的研究轨道。随之而来的挑战包括:
- 评测改革:从静态识别转向长时程、跨事件链条的测评;从单模态准确率到跨模态一致性、因果可验证性。
- 数据与平台:需要高质量的交互式环境与多传感数据,提升从仿真到现实(sim-to-real)的可迁移性。
- 安全与边界:具身系统引入现实风险,要求策略安全、失败可控与干预可行。
从“视觉与语言”到“多媒体与语言”,以及“生成×基础模型”的融合
主题从“视觉与语言”扩展为“多媒体与语言”,正式把音频与传感器数据纳入对齐、对话与推理的主舞台。这意味着:
- 语言将成为多模态的“控制面板”,同时也承担记忆、计划与工具调用的统一接口。
- 音频、触觉、环境状态等曾被视作“补充”的模态,现在成为一等公民,促使研究走向更贴近现实的“跨通道对齐与协同”。
同时,“多媒体基础模型”与“生成式多媒体”合并为“多媒体生成与基础模型”。这不是简单的并栏,而是承认两者在三方面的内在耦合:
- 架构统一:跨模态预训练与扩散/自回归生成越来越一体化。
- 对齐先行:没有稳健的跨模态对齐,生成即难以可控与可信。
- 可控生成:从提示增强到结构化约束,再到语义/物理一致性的多重控制,成为评价生成质量的新标准。
实践中,这将推动诸如“语音驱动的视频编辑”“多传感器日志到情景再现”“语言指令到交互动作”等方向的系统性进步。
从“社会影响”到“负责任的多媒体”,再到“可理解性与可解释性”
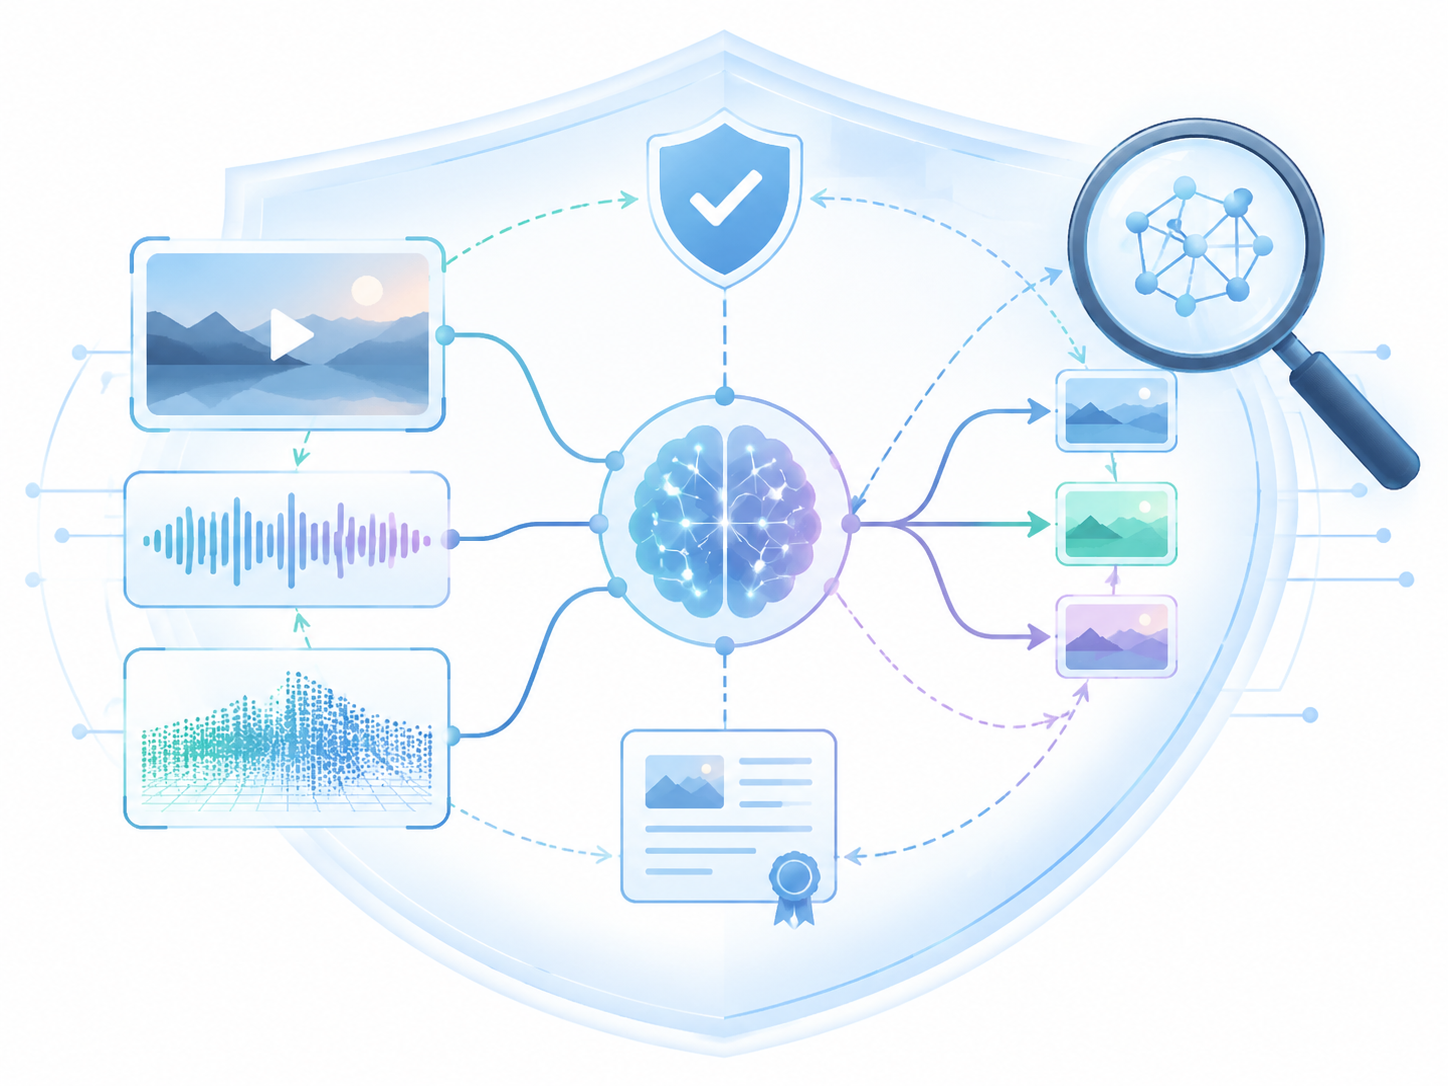
主题从关注“生成式AI的社会影响”过渡为“负责任的多媒体”,并将“可理解性与可解释性”单列强化。信号非常明确:影响已成定局,接下来是承担与治理。
- 责任维度:内容溯源与水印、深度伪造治理、数据与版权合规、偏见与歧视缓解、可追责的评测与审计。
- 可理解性 vs 可解释性:前者更关心模型内部机制与表征透明,后者强调对具体判断的依据说明。随着模型进入“判断—决策—行动”的链路,仅给答案远远不够,必须提供可审计的理由。
这也将催生新的方法与基准:结构化解释、因果证据链、反事实分析、跨模态一致性的解释校验等。
影响与展望
- 对学术界:研究版图的重绘意味着问题定义与评测范式的升级。具身与推理促使数据集从静态标注走向交互轨迹与事件链;生成与基础模型的融合要求在一套框架里同时优化对齐、记忆与控制。跨社区协作(视觉、语音、NLP、HCI、机器人)将成为常态。
- 对产业界:多媒体系统正从“内容平台”升级为“交互智能体”。AR/VR、智能硬件、数字人、智能客服、工业巡检与智慧零售场景,将受益于跨模态对齐、可控生成与长时推理能力的提升。与此同时,内容溯源、模型审计与安全干预将成为产品化的必备组件。
- 对评测与治理:需要覆盖长时程、跨模态、因果一致性的综合指标,以及“从仿真到现实”的迁移测试;在责任维度,引入水印与 provenance 标准、红队测试流程、使用边界与人机共治机制。
可以预见,多媒体的内涵正在从“看懂内容”扩展为“理解世界、做出决策、承担后果”。这次ACM MM的主题重划,既不是对传统研究的告别,也不是向机器人硬件的转场,而是顺应AI整体范式的迁移:从感知到推理,从生成到控制,从影响到责任。下一阶段的竞争,将围绕三件事展开——更强的跨模态对齐、更稳的因果与长程推理、更可审计的负责任机制。
标签: ACM MM 多模态 具身智能 多媒体推理 负责任AI
还没有评论
发表评论